Naive Bayes untuk Prediksi Kelulusan Tepat Waktu: Menghitung Probabilitas Langkah demi Langkah
Panduan lengkap memahami Naive Bayes perhitungan manual untuk memprediksi kelulusan mahasiswa, disertai hitungan prior, likelihood, Laplace smoothing, dan perbandingannya.
Oleh Ade Taopik Hidayatuloh, S.Kom., M.Kom. 10 menit baca
Daftar isi
- Fondasi Teorema Bayes dan Asumsi Independensi
- Penerapan Naive Bayes Perhitungan Manual pada Data Latih
- Menghitung Tabel Likelihood Setiap Atribut
- Klasifikasi Data Baru dan Masalah Probabilitas Nol
- Penerapan Laplace Smoothing
- Perhitungan Posterior Terkoreksi dan Penentuan Kelas
- Dari Hitungan Manual ke Program
- Karakteristik dan Kapan Naive Bayes Tepat Digunakan
Ketika menyusun skripsi bertema pembelajaran mesin, penguji sidang sering kali tidak puas bila mahasiswa hanya menampilkan grafik akurasi dari pustaka pemrograman. Pertanyaan yang hampir pasti diajukan di ruang sidang adalah bagaimana algoritma tersebut mengambil keputusan dari data mentah. Untuk menunjukkan pemahaman konsep yang kokoh, menguasai naive bayes perhitungan manual menjadi modal utama yang membuktikan bahwa Anda memahami probabilitas di balik kode program.
Naive Bayes merupakan algoritma klasifikasi berbasis Teorema Bayes yang bersandar pada prinsip probabilitas bersyarat. Algoritma ini memprediksi peluang suatu data masuk ke dalam kelas tertentu berdasarkan kombinasi nilai atribut yang dimilikinya. Daya tarik utama Naive Bayes terletak pada kesederhanaan matematis dan kecepatannya saat memproses data berdimensi tinggi.
Fondasi Teorema Bayes dan Asumsi Independensi
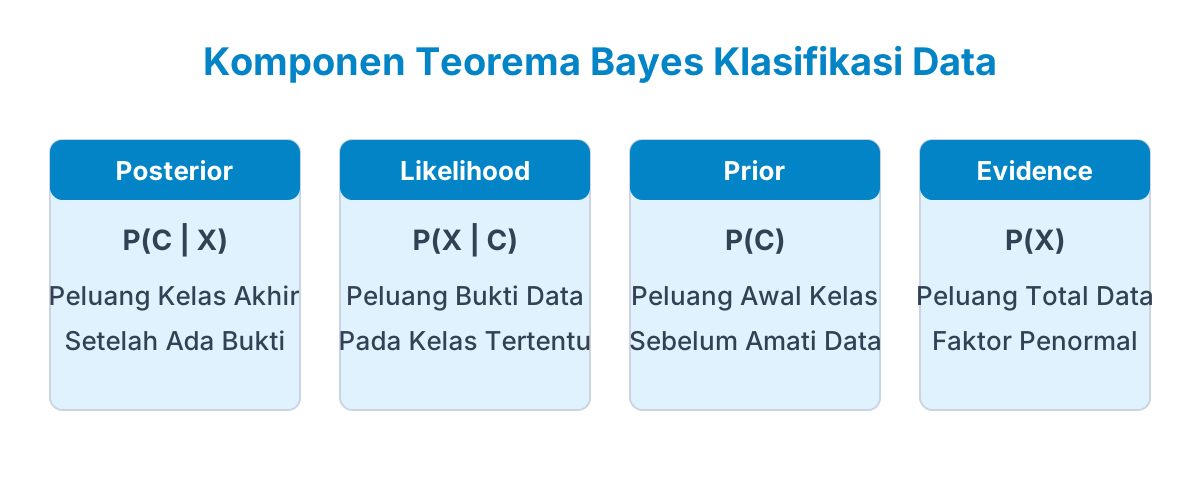
Komponen utama Teorema Bayes: Posterior, Likelihood, Prior, dan Evidence. Sumber: diagram oleh Metodika.
Teorema Bayes dirumuskan oleh Thomas Bayes untuk menghitung probabilitas terjadinya suatu peristiwa berdasarkan informasi awal yang berkaitan. Rumus dasar Teorema Bayes dinyatakan sebagai berikut:
\[ P(C \mid X) = \frac{P(X \mid C)\, P(C)}{P(X)} \]
dengan \(P(C \mid X)\) adalah probabilitas posterior terjadinya kelas target \(C\) untuk atribut \(X\), \(P(X \mid C)\) adalah likelihood munculnya kombinasi atribut \(X\) jika diketahui kelasnya \(C\), \(P(C)\) adalah probabilitas prior dari kelas \(C\), dan \(P(X)\) adalah probabilitas marjinal (evidence) atribut \(X\).
Berdasarkan asumsi independensi kondisional pada Naive Bayes, perkalian likelihood dihitung dengan rumus:
\[ P(X \mid C) = \prod_{j=1}^{p} P(X_j \mid C) \]
dengan \(p\) adalah jumlah atribut dan \(X_j\) adalah nilai atribut ke-\(j\).
Kata "Naive" atau naif disematkan karena algoritma ini mengasumsikan bahwa semua atribut saling bebas atau independen secara kondisional terhadap kelas target. Artinya, keberadaan nilai pada atribut IPK dianggap tidak memengaruhi nilai pada atribut kehadiran maupun keaktifan organisasi. Meskipun di dunia nyata asumsi independensi ini jarang terpenuhi secara mutlak, Naive Bayes terbukti bekerja sangat baik pada berbagai persoalan klasifikasi praktis.
Penerapan Naive Bayes Perhitungan Manual pada Data Latih
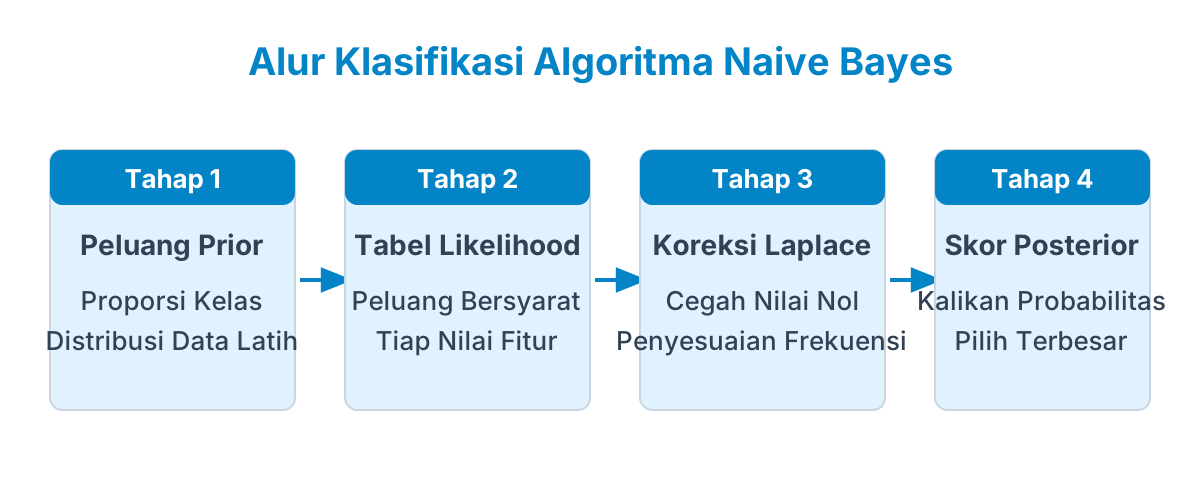
Tahapan komputasi Naive Bayes dari prior hingga penentuan kelas posterior. Sumber: diagram oleh Metodika.
Perhatikan contoh kasus prediksi kelulusan mahasiswa di Program Studi Informatika Universitas A (contoh). Kita ingin memprediksi apakah seorang mahasiswa akan lulus Tepat Waktu atau Terlambat berdasarkan tiga atribut: IPK Semester 4, Tingkat Kehadiran Kuliah, dan Keaktifan Organisasi Kemahasiswaan.
Berikut adalah tabel data latih sederhana yang memuat 6 data mahasiswa (contoh):
| No | Nama Mahasiswa | IPK (X1) | Kehadiran (X2) | Organisasi (X3) | Status Kelulusan (Y) |
|---|---|---|---|---|---|
| 1 | Mahasiswa M1 (contoh) | Tinggi | Baik | Pasif | Tepat |
| 2 | Mahasiswa M2 (contoh) | Tinggi | Cukup | Aktif | Tepat |
| 3 | Mahasiswa M3 (contoh) | Sedang | Baik | Pasif | Tepat |
| 4 | Mahasiswa M4 (contoh) | Sedang | Cukup | Aktif | Terlambat |
| 5 | Mahasiswa M5 (contoh) | Sedang | Kurang | Aktif | Terlambat |
| 6 | Mahasiswa M6 (contoh) | Rendah | Kurang | Pasif | Terlambat |
Dari tabel data latih berukuran 6 baris tersebut, kita memiliki dua kelas target, yaitu Tepat (3 data) dan Terlambat (3 data). Tahap pertama adalah menghitung probabilitas prior untuk masing-masing kelas target:
\[ P(\text{Tepat}) = \frac{3}{6} = 0{,}5 \qquad P(\text{Terlambat}) = \frac{3}{6} = 0{,}5 \]
Menghitung Tabel Likelihood Setiap Atribut
Langkah berikutnya adalah menghitung likelihood \(P(X_j \mid C)\) untuk setiap variasi nilai atribut pada masing-masing kelas target.
1. Atribut IPK (\(X_1\)) memiliki tiga kemungkinan nilai: Tinggi, Sedang, dan Rendah.
- Untuk kelas Tepat (total 3 mahasiswa): Tinggi muncul 2 kali (M1, M2), Sedang muncul 1 kali (M3), Rendah muncul 0 kali. Maka \(P(\text{Tinggi} \mid \text{Tepat}) = \frac{2}{3} \approx 0{,}6667\); \(P(\text{Sedang} \mid \text{Tepat}) = \frac{1}{3} \approx 0{,}3333\); \(P(\text{Rendah} \mid \text{Tepat}) = \frac{0}{3} = 0\).
- Untuk kelas Terlambat (total 3 mahasiswa): Tinggi muncul 0 kali, Sedang muncul 2 kali (M4, M5), Rendah muncul 1 kali (M6). Maka \(P(\text{Tinggi} \mid \text{Terlambat}) = \frac{0}{3} = 0\); \(P(\text{Sedang} \mid \text{Terlambat}) = \frac{2}{3} \approx 0{,}6667\); \(P(\text{Rendah} \mid \text{Terlambat}) = \frac{1}{3} \approx 0{,}3333\).
2. Atribut Kehadiran (\(X_2\)) memiliki tiga kemungkinan nilai: Baik, Cukup, dan Kurang.
- Untuk kelas Tepat: Baik muncul 2 kali (M1, M3), Cukup muncul 1 kali (M2), Kurang muncul 0 kali. Maka \(P(\text{Baik} \mid \text{Tepat}) = \frac{2}{3} \approx 0{,}6667\); \(P(\text{Cukup} \mid \text{Tepat}) = \frac{1}{3} \approx 0{,}3333\); \(P(\text{Kurang} \mid \text{Tepat}) = \frac{0}{3} = 0\).
- Untuk kelas Terlambat: Baik muncul 0 kali, Cukup muncul 1 kali (M4), Kurang muncul 2 kali (M5, M6). Maka \(P(\text{Baik} \mid \text{Terlambat}) = \frac{0}{3} = 0\); \(P(\text{Cukup} \mid \text{Terlambat}) = \frac{1}{3} \approx 0{,}3333\); \(P(\text{Kurang} \mid \text{Terlambat}) = \frac{2}{3} \approx 0{,}6667\).
3. Atribut Organisasi (\(X_3\)) memiliki dua kemungkinan nilai: Aktif dan Pasif.
- Untuk kelas Tepat: Aktif muncul 1 kali (M2), Pasif muncul 2 kali (M1, M3). Maka \(P(\text{Aktif} \mid \text{Tepat}) = \frac{1}{3} \approx 0{,}3333\); \(P(\text{Pasif} \mid \text{Tepat}) = \frac{2}{3} \approx 0{,}6667\).
- Untuk kelas Terlambat: Aktif muncul 2 kali (M4, M5), Pasif muncul 1 kali (M6). Maka \(P(\text{Aktif} \mid \text{Terlambat}) = \frac{2}{3} \approx 0{,}6667\); \(P(\text{Pasif} \mid \text{Terlambat}) = \frac{1}{3} \approx 0{,}3333\).
Klasifikasi Data Baru dan Masalah Probabilitas Nol
Sekarang datang data mahasiswa baru yang hendak diprediksi kelulusannya, sebut saja Mahasiswa Uji (contoh). Profil mahasiswa baru tersebut adalah:
- IPK = Sedang
- Kehadiran = Baik
- Organisasi = Aktif
Jika kita langsung mengalikan prior dan likelihood sesuai rumus Naive Bayes standar:
Untuk kelas Tepat:
\[ P(\text{Tepat} \mid X) \propto P(\text{Tepat}) \times P(\text{Sedang} \mid \text{Tepat}) \times P(\text{Baik} \mid \text{Tepat}) \times P(\text{Aktif} \mid \text{Tepat}) \]
\[ = 0{,}5 \times \frac{1}{3} \times \frac{2}{3} \times \frac{1}{3} = \frac{2}{54} = \frac{1}{27} \approx 0{,}0370 \]
Untuk kelas Terlambat:
\[ P(\text{Terlambat} \mid X) \propto P(\text{Terlambat}) \times P(\text{Sedang} \mid \text{Terlambat}) \times P(\text{Baik} \mid \text{Terlambat}) \times P(\text{Aktif} \mid \text{Terlambat}) \]
\[ = 0{,}5 \times \frac{2}{3} \times \frac{0}{3} \times \frac{2}{3} = 0 \]
Di sini muncul masalah mendasar pada Naive Bayes, yaitu fenomena probabilitas nol (zero probability problem). Karena nilai Kehadiran Baik belum pernah ada pada data mahasiswa yang terlambat di data latih kita, nilai likelihood \(P(\text{Baik} \mid \text{Terlambat})\) bernilai nol. Perkalian dengan angka nol menghapus pengaruh atribut lain seperti IPK Sedang dan Organisasi Aktif yang sebetulnya kuat mengarah ke kelas Terlambat. Untuk mengatasi masalah ini, kita menerapkan teknik Laplace smoothing.
Penerapan Laplace Smoothing
Laplace smoothing menambahkan bobot 1 pada frekuensi kemunculan atribut di pembilang dan menambahkan jumlah variasi kategori (k) pada penyebut. Rumus penyesuaiannya adalah:
\[ P(X_j = x \mid C) = \frac{n_{jc} + 1}{n_c + k} \]
dengan \(n_{jc}\) adalah frekuensi kemunculan nilai atribut \(x\) pada kelas \(C\), \(n_c\) adalah jumlah total data latih pada kelas \(C\) (dalam contoh ini \(n_c = 3\)), dan \(k\) adalah jumlah kategori unik pada atribut tersebut (untuk IPK \(k = 3\), untuk Kehadiran \(k = 3\), dan untuk Organisasi \(k = 2\)).
Kini hitung ulang likelihood untuk profil Mahasiswa Uji menggunakan Laplace smoothing:
| Atribut | Nilai Uji | Likelihood Kelas Tepat (\(n_c=3\)) | Likelihood Kelas Terlambat (\(n_c=3\)) |
|---|---|---|---|
| IPK (\(k=3\)) | Sedang | \(\frac{1 + 1}{3 + 3} = \frac{2}{6} = \frac{1}{3} \approx 0{,}3333\) | \(\frac{2 + 1}{3 + 3} = \frac{3}{6} = \frac{1}{2} = 0{,}5000\) |
| Kehadiran (\(k=3\)) | Baik | \(\frac{2 + 1}{3 + 3} = \frac{3}{6} = \frac{1}{2} = 0{,}5000\) | \(\frac{0 + 1}{3 + 3} = \frac{1}{6} \approx 0{,}1667\) |
| Organisasi (\(k=2\)) | Aktif | \(\frac{1 + 1}{3 + 2} = \frac{2}{5} = 0{,}4000\) | \(\frac{2 + 1}{3 + 2} = \frac{3}{5} = 0{,}6000\) |
Sekarang nilai likelihood Kehadiran Baik pada kelas Terlambat berubah dari 0 menjadi \(\frac{1}{6} \approx 0{,}1667\). Tidak ada lagi pembagian atau perkalian yang menyebabkan hasil runtuh menjadi nol.
Perhitungan Posterior Terkoreksi dan Penentuan Kelas
Dengan likelihood yang telah dihaluskan, kita hitung nilai probabilitas posterior terkoreksi untuk kedua kelas:
1. Posterior Kelas Tepat:
\[ P(\text{Tepat} \mid X) \propto 0{,}5 \times \frac{2}{6} \times \frac{3}{6} \times \frac{2}{5} = \frac{1}{2} \times \frac{1}{3} \times \frac{1}{2} \times \frac{2}{5} = \frac{2}{60} = \frac{1}{30} \approx 0{,}0333 \]
2. Posterior Kelas Terlambat:
\[ P(\text{Terlambat} \mid X) \propto 0{,}5 \times \frac{3}{6} \times \frac{1}{6} \times \frac{3}{5} = \frac{1}{2} \times \frac{1}{2} \times \frac{1}{6} \times \frac{3}{5} = \frac{3}{120} = \frac{1}{40} = 0{,}0250 \]
Untuk menyajikan angka yang mudah dipahami penguji sidang, kita lakukan normalisasi agar total probabilitas kedua kelas berjumlah 100 persen:
\[ \text{Total} = \frac{1}{30} + \frac{1}{40} = \frac{4}{120} + \frac{3}{120} = \frac{7}{120} \approx 0{,}0583 \]
\[ P(\text{Tepat} \mid X) = \frac{1/30}{7/120} = \frac{4}{7} \approx 0{,}5714\ (57{,}14\%) \]
\[ P(\text{Terlambat} \mid X) = \frac{1/40}{7/120} = \frac{3}{7} \approx 0{,}4286\ (42{,}86\%) \]
Hasil perhitungan menunjukkan peluang lulus Tepat Waktu sebesar \(57{,}14\%\), sedangkan peluang Terlambat adalah \(42{,}86\%\). Berdasarkan aturan keputusan probabilitas tertinggi, sistem memprediksi Mahasiswa Uji akan lulus Tepat Waktu.
Dari Hitungan Manual ke Program
Dalam naskah skripsi Bab IV, setelah Anda menyajikan langkah matematis di atas, barulah Anda memaparkan bagaimana algoritma tersebut diimplementasikan ke dalam kode program Python menggunakan modul CategoricalNB dari pustaka Scikit-Learn.
from sklearn.naive_bayes import CategoricalNB
import numpy as np

X_train = np.array([[2, 2, 0], [2, 1, 1], [1, 2, 0], [1, 1, 1], [1, 0, 1], [0, 0, 0]])
y_train = np.array([1, 1, 1, 0, 0, 0])
model = CategoricalNB(alpha=1.0)
model.fit(X_train, y_train)
prediksi = model.predict([[1, 2, 1]])
Kode di atas adalah potongan logika inti pemodelan menggunakan parameter alpha bernilai 1.0 yang merepresentasikan Laplace smoothing, bukan keseluruhan aplikasi sistem prediksi mahasiswa.
Jika dalam penelitian Anda data memiliki karakteristik kontinu seperti nilai numerik murni tanpa rentang kategori, Anda dapat mempertimbangkan pendekatan jarak seperti pada K-Nearest Neighbor (KNN) atau arsitektur pembelajaran mendalam seperti Convolutional Neural Network (CNN) bila mengolah data citra.
Karakteristik dan Kapan Naive Bayes Tepat Digunakan
Naive Bayes sangat efisien digunakan ketika dataset penelitian Anda didominasi atribut bertipe diskret atau kategorikal, seperti status kepegawaian, riwayat nilai huruf, atau fitur berbasis teks dalam analisis sentimen. Keunggulan komputasinya membuat model ini mampu melatih ribuan baris data hanya dalam hitungan detik dengan konsumsi memori yang sangat hemat.
Namun, Anda harus berhati-hati apabila variabel penelitian Anda memiliki korelasi yang sangat erat satu sama lain. Asumsi independensi akan membuat bobot variabel yang berkorelasi dihitung ganda sehingga probabilitas prediksi menjadi terlalu optimis. Oleh sebab itu, pemeriksaan korelasi antarvariabel pada Bab III penelitian menjadi bagian penting sebelum menetapkan Naive Bayes sebagai metode utama.
Bagi mahasiswa atau peneliti yang sedang menyelesaikan implementasi algoritma klasifikasi dan membutuhkan pendampingan teknis dalam merancang arsitektur model, evaluasi matriks konfusi, atau penulisan naskah komputasi, Anda dapat memanfaatkan layanan bimbingan source code penelitian AI untuk memastikan penelitian Anda selesai secara sistematis dan siap dipertanggungjawabkan di hadapan dewan penguji.
Gambar sampul: ilustrasi oleh Metodika.
Bagikan artikel ini
Komentar
Belum ada komentar. Jadilah yang pertama berdiskusi.