Pohon Keputusan C4.5: Menghitung Entropy dan Gain untuk Menentukan Akar Pohon
Panduan teknis algoritma C4.5 perhitungan manual: memahami konsep pohon keputusan, rumus entropy dan information gain, uji split info, hingga pembentukan aturan jika-maka.
Oleh Ade Taopik Hidayatuloh, S.Kom., M.Kom. 11 menit baca
Daftar isi
- Konsep Dasar Pohon Keputusan dan Aturan Klasifikasi
- Rumus Matematika Entropy, Information Gain, dan Gain Ratio
- Langkah Demi Langkah Algoritma C4.5 Perhitungan Manual
- Membaca Struktur Pohon Menjadi Kaidah Keputusan Jika-Maka
- Gain Ratio: Keunggulan Algoritma C4.5 Dibandingkan ID3
- Dari Hitungan Manual ke Program
- Referensi
Dalam rumpun machine learning dan kecerdasan buatan, pohon keputusan tetap menjadi salah satu algoritma klasifikasi paling populer karena strukturnya yang transparan dan mudah diinterpretasikan oleh manusia. Berbeda dengan model kotak hitam yang sulit dilacak logika penalarannya, algoritma C4.5 perhitungan manual memperlihatkan secara gamblang bagaimana setiap keputusan klasifikasi diturunkan dari pola data pelatihan. Melalui pemahaman hitungan dasar, Anda tidak hanya mengandalkan pustaka program siap pakai, melainkan benar-benar menguasai matematika di balik pemecahan simpul pohon.
Algoritma C4.5 yang dikembangkan oleh Ross Quinlan merupakan penyempurnaan langsung dari algoritma pendahulunya, yaitu ID3. Kelemahan utama ID3 yang cenderung memilih atribut dengan variasi nilai terbanyak berhasil diatasi oleh C4.5 melalui pengenalan metrik gain ratio. Dalam artikel ini, kita menelaah konsep dasar pohon keputusan, menelusuri rumus entropy dan gain, serta mempraktikkan hitungan manual langkah demi langkah hingga menghasilkan diagram pohon keputusan yang siap diterjemahkan ke dalam aturan jika-maka.
Konsep Dasar Pohon Keputusan dan Aturan Klasifikasi
Pohon keputusan adalah representasi visual dari alur klasifikasi yang menyerupai struktur pohon terbalik. Model ini dimulai dari satu simpul paling atas yang disebut simpul akar (root node). Dari simpul akar, data dipecah ke dalam beberapa cabang berdasarkan nilai atribut tertentu. Proses pemecahan data terus berlanjut melewati simpul internal (internal node) hingga akhirnya berhenti pada simpul daun (leaf node), yaitu simpul ujung yang memuat label kelas prediksi.
Keunggulan filosofis pohon keputusan terletak pada kemampuannya memecah masalah pengambilan keputusan yang kompleks menjadi serangkaian aturan sederhana. Setiap lintasan dari simpul akar menuju daun membentuk satu kaidah klasifikasi berformat jika-maka (if-then rules). Pendekatan inferensi ini sangat relevan untuk sistem pakar dan analisis risiko di mana pengguna membutuhkan alasan logis di balik setiap rekomendasi sistem, mirip dengan penalaran berbasis probabilitas pada algoritma Naive Bayes.
Dalam membangun pohon keputusan yang optimal, tantangan terbesarnya adalah menentukan atribut mana yang paling berhak dijadikan simpul akar dan simpul pemecah berikutnya. Jika urutan atribut keliru, ukuran pohon akan membengkak, menghasilkan cabang yang redundan, dan mudah mengalami *overfitting*. Algoritma C4.5 menjawab tantangan ini menggunakan prinsip teori informasi (information theory).
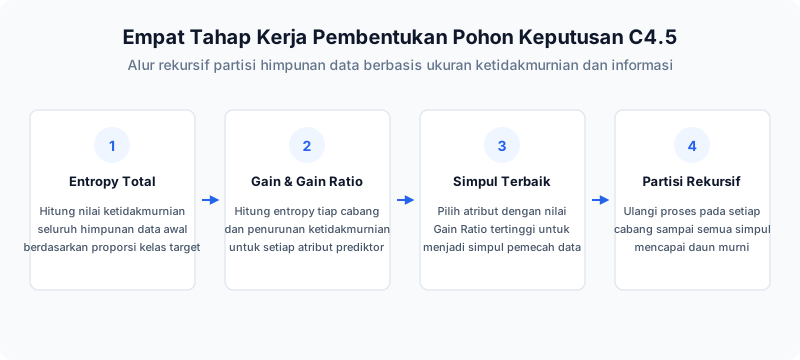
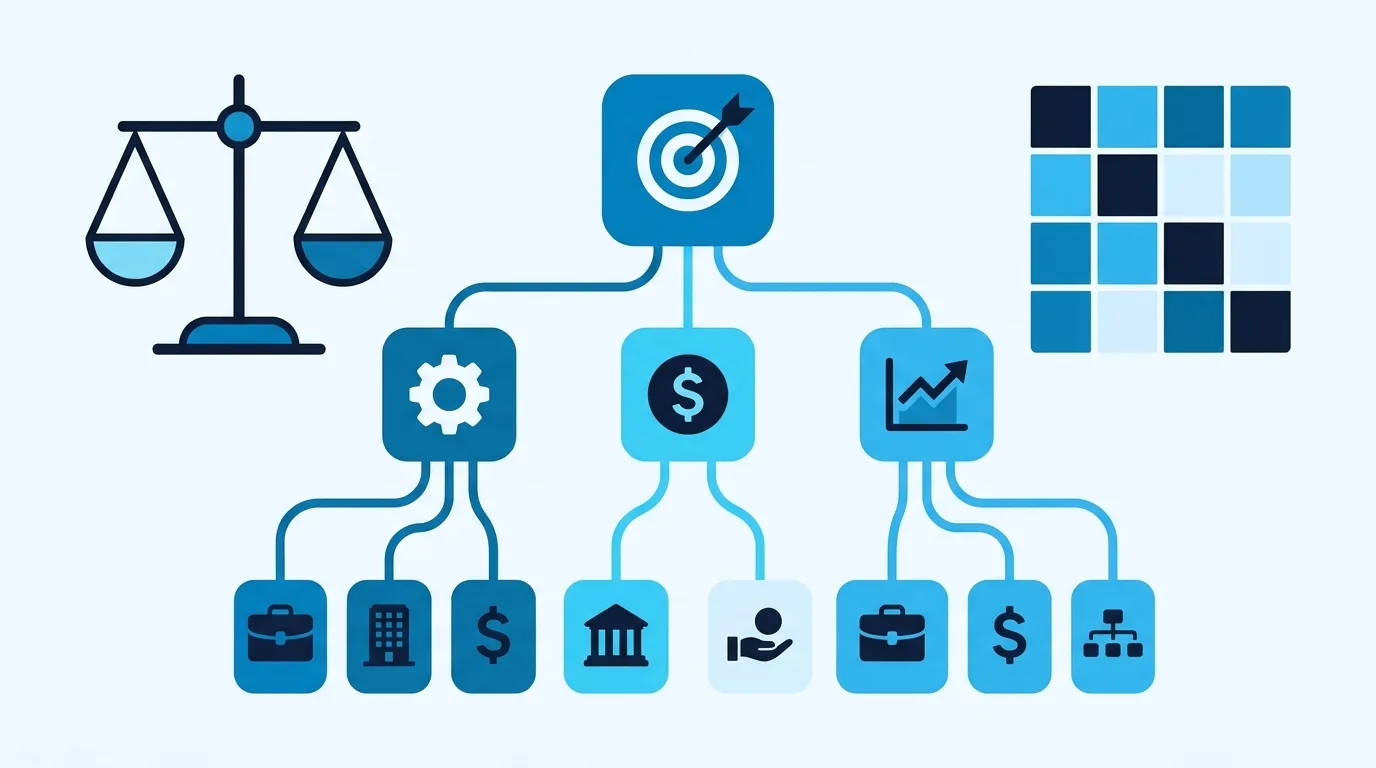
Empat tahap pembentukan pohon keputusan C4.5 dari perhitungan entropy hingga partisi rekursif. Sumber: diagram oleh Metodika.
Rumus Matematika Entropy, Information Gain, dan Gain Ratio
Untuk mengukur tingkat ketidakteraturan atau keacakan suatu kumpulan data, algoritma C4.5 meminjam konsep termodinamika yang diadaptasi oleh Claude Shannon ke dalam teori informasi, yaitu entropy. Semakin homogen suatu himpunan data, semakin rendah nilai entropynya. Jika seluruh data dalam suatu himpunan memiliki kelas target yang sama, nilai entropy bernilai 0 (murni sempurna). Sebaliknya, jika data terbagi sama rata antar-kelas, nilai entropy mencapai nilai maksimum 1.
Secara matematis, rumus entropy untuk himpunan sampel data \(S\) dengan \(c\) kelas target dirumuskan sebagai berikut:
\[ \mathrm{Entropy}(S) = -\sum_{i=1}^{c} p_i \log_2 (p_i) \]
dengan \(S\) adalah himpunan kasus sampel data, \(c\) adalah jumlah kelas target klasifikasi, dan \(p_i\) menyatakan proporsi atau peluang munculnya kelas ke-\(i\) terhadap total data dalam himpunan \(S\). Jika suatu kelas bernilai 0, maka nilai \(p_i \log_2(p_i)\) didefinisikan bernilai 0.
Setelah menghitung entropy himpunan sebelum dipecah, langkah berikutnya adalah mengukur efektivitas atribut \(A\) dalam mereduksi ketidakteraturan. Besaran penurunan ketidakteraturan ini disebut Information Gain, yang dihitung dengan rumus:
\[ \mathrm{Gain}(S, A) = \mathrm{Entropy}(S) - \sum_{v \in \mathrm{Values}(A)} \frac{|S_v|}{|S|} \mathrm{Entropy}(S_v) \]
dengan \(A\) adalah atribut prediktor yang diuji, \(\mathrm{Values}(A)\) adalah seluruh kemungkinan nilai cabang pada atribut \(A\), \(S_v\) adalah subset data di mana atribut \(A\) bernilai \(v\), dan \(|S|\) menyatakan kardinalitas atau jumlah elemen himpunan data.
Pada algoritma C4.5, pemilihan atribut tidak berhenti pada nilai gain tertinggi, melainkan dinormalisasi menggunakan besaran Split Information. Split Information menghukum atribut yang memecah data menjadi terlalu banyak subset kecil. Rumusnya adalah:
\[ \mathrm{SplitInfo}(S, A) = -\sum_{v \in \mathrm{Values}(A)} \frac{|S_v|}{|S|} \log_2 \left(\frac{|S_v|}{|S|}\right) \]
Nilai seleksi final diperoleh dengan membagi Information Gain terhadap Split Information, menghasilkan metrik Gain Ratio:
\[ \mathrm{GainRatio}(S, A) = \frac{\mathrm{Gain}(S, A)}{\mathrm{SplitInfo}(S, A)} \]
Langkah Demi Langkah Algoritma C4.5 Perhitungan Manual
Agar konsep teoretis di atas terbukti nyata, kita akan menyelesaikan studi kasus algoritma C4.5 perhitungan manual secara tuntas menggunakan dataset sederhana. Misalkan sebuah program beasiswa di Universitas Nusantara (nama samaran berlabel contoh) memiliki 6 data riwayat pelamar dengan tiga atribut prediktor: IPK (Tinggi, Sedang), Kondisi Ekonomi Orang Tua (Rendah, Mampu), dan Keaktifan Organisasi (Aktif, Pasif). Target klasifikasi adalah status penerimaan: Ya atau Tidak.
| No | IPK | Penghasilan Ortu | Organisasi | Diterima |
|---|---|---|---|---|
| 1 | Tinggi | Rendah | Aktif | Ya |
| 2 | Tinggi | Mampu | Aktif | Ya |
| 3 | Tinggi | Rendah | Pasif | Ya |
| 4 | Sedang | Rendah | Aktif | Ya |
| 5 | Sedang | Mampu | Aktif | Tidak |
| 6 | Sedang | Mampu | Pasif | Tidak |
Langkah pertama adalah menghitung Entropy Total himpunan data awal \(S\). Dari total \(|S| = 6\) baris data, terdapat \(4\) pelamar yang berstatus Ya dan \(2\) pelamar berstatus Tidak. Proporsinya adalah \(p_{\text{Ya}} = \frac{4}{6}\) dan \(p_{\text{Tidak}} = \frac{2}{6}\). Perhitungan entropynya adalah:
\[ \mathrm{Entropy}(S) = -\left[ \frac{4}{6} \log_2 \left(\frac{4}{6}\right) + \frac{2}{6} \log_2 \left(\frac{2}{6}\right) \right] \approx 0{,}9183 \]
Langkah kedua adalah menguji atribut pertama, yaitu IPK. Atribut IPK memiliki dua cabang nilai:
- IPK = Tinggi: Memiliki 3 data (No 1, 2, 3), semuanya berstatus Ya (\(3\) Ya, \(0\) Tidak). Karena seluruhnya homogen, nilainya murni: \(\mathrm{Entropy}(S_{\text{Tinggi}}) = 0{,}0000\).
- IPK = Sedang: Memiliki 3 data (No 4, 5, 6), terdiri atas \(1\) Ya dan \(2\) Tidak. Nilainya: \(\mathrm{Entropy}(S_{\text{Sedang}}) = -\left[ \frac{1}{3} \log_2 \left(\frac{1}{3}\right) + \frac{2}{3} \log_2 \left(\frac{2}{3}\right) \right] \approx 0{,}9183\).
Berdasarkan kedua cabang tersebut, kita hitung Information Gain untuk atribut IPK:
\[ \mathrm{Gain}(S, \text{IPK}) = 0{,}9183 - \left[ \frac{3}{6} (0{,}0000) + \frac{3}{6} (0{,}9183) \right] = 0{,}9183 - 0{,}4591 = 0{,}4591 \]
Split Information untuk IPK yang terbagi rata 3 dan 3 adalah \(\mathrm{SplitInfo}(S, \text{IPK}) = -\left[ \frac{3}{6} \log_2 \left(\frac{3}{6}\right) + \frac{3}{6} \log_2 \left(\frac{3}{6}\right) \right] = 1{,}0000\). Maka Gain Ratio untuk IPK adalah \(\mathrm{GainRatio}(S, \text{IPK}) = \frac{0{,}4591}{1{,}0000} = 0{,}4591\).
Langkah ketiga adalah menguji atribut kedua, yaitu Penghasilan Orang Tua. Terdapat dua cabang:
- Penghasilan = Rendah: Memiliki 3 data (No 1, 3, 4), terdiri atas \(2\) Ya dan \(1\) Tidak. Nilai \(\mathrm{Entropy}(S_{\text{Rendah}}) = 0{,}9183\).
- Penghasilan = Mampu: Memiliki 3 data (No 2, 5, 6), terdiri atas \(2\) Ya dan \(1\) Tidak. Nilai \(\mathrm{Entropy}(S_{\text{Mampu}}) = 0{,}9183\).
\[ \mathrm{Gain}(S, \text{Penghasilan}) = 0{,}9183 - \left[ \frac{3}{6} (0{,}9183) + \frac{3}{6} (0{,}9183) \right] = 0{,}0000 \]
Dengan demikian, \(\mathrm{GainRatio}(S, \text{Penghasilan}) = 0{,}0000\).
Langkah keempat adalah menguji atribut ketiga, yaitu Keaktifan Organisasi:
- Organisasi = Aktif: Memiliki 4 data (No 1, 2, 4, 5), terdiri atas \(3\) Ya dan \(1\) Tidak. Nilai \(\mathrm{Entropy}(S_{\text{Aktif}}) = -\left[ \frac{3}{4} \log_2 \left(\frac{3}{4}\right) + \frac{1}{4} \log_2 \left(\frac{1}{4}\right) \right] \approx 0{,}8113\).
- Organisasi = Pasif: Memiliki 2 data (No 3, 6), terdiri atas \(1\) Ya dan \(1\) Tidak. Nilai \(\mathrm{Entropy}(S_{\text{Pasif}}) = 1{,}0000\).
\[ \mathrm{Gain}(S, \text{Organisasi}) = 0{,}9183 - \left[ \frac{4}{6} (0{,}8113) + \frac{2}{6} (1{,}0000) \right] = 0{,}9183 - (0{,}5409 + 0{,}3333) = 0{,}0441 \]
Split Information organisasi adalah \(\mathrm{SplitInfo} = -\left[ \frac{4}{6} \log_2 \left(\frac{4}{6}\right) + \frac{2}{6} \log_2 \left(\frac{2}{6}\right) \right] \approx 0{,}9183\), sehingga \(\mathrm{GainRatio}(S, \text{Organisasi}) = \frac{0{,}0441}{0{,}9183} \approx 0{,}0480\).
| Atribut | Entropy Bobot | Information Gain | Split Information | Gain Ratio |
|---|---|---|---|---|
| IPK | 0,4591 | 0,4591 | 1,0000 | 0,4591 |
| Penghasilan | 0,9183 | 0,0000 | 1,0000 | 0,0000 |
| Organisasi | 0,8742 | 0,0441 | 0,9183 | 0,0480 |
Dari tabel rekapitulasi di atas, atribut IPK terpilih sebagai simpul akar (root node) karena memiliki nilai Gain Ratio tertinggi (\(0{,}4591\)). Cabang IPK Tinggi langsung tuntas menjadi daun murni berlabel Ya. Sementara itu, cabang IPK Sedang masih memuat data campuran (No 4, 5, 6) sehingga proses rekursif dilanjutkan pada cabang tersebut.
Membaca Struktur Pohon Menjadi Kaidah Keputusan Jika-Maka
Pada subset cabang IPK Sedang yang menyisakan data No 4 (Rendah, Aktif, Ya), No 5 (Mampu, Aktif, Tidak), dan No 6 (Mampu, Pasif, Tidak), kita menguji dua atribut yang tersisa. Jika atribut Penghasilan diuji pada cabang ini, kategori Rendah memuat 1 data murni berlabel Ya, sedangkan kategori Mampu memuat 2 data murni berlabel Tidak. Nilai entropy langsung mencapai 0, sehingga proses partisi berhenti sempurna.
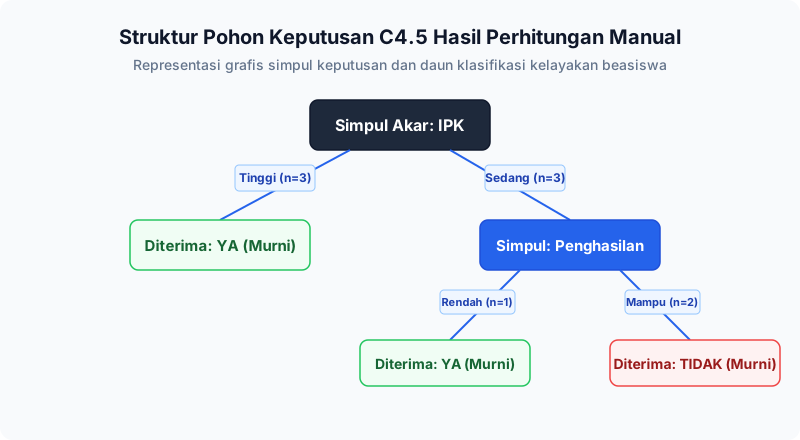
Pohon keputusan klasifikasi dengan simpul akar IPK dan cabang lanjutan kondisi ekonomi. Sumber: diagram oleh Metodika.
Dari diagram pohon keputusan yang terbentuk pada gambar di atas, kita dapat mengekstrak aturan klasifikasi yang sangat ringkas dan mudah dibaca oleh pemangku kebijakan kampus:
- Aturan 1: JIKA IPK = Tinggi MAKA Status = Diterima (Ya).
- Aturan 2: JIKA IPK = Sedang DAN Penghasilan Ortu = Rendah MAKA Status = Diterima (Ya).
- Aturan 3: JIKA IPK = Sedang DAN Penghasilan Ortu = Mampu MAKA Status = Tidak Diterima (Tidak).
Kaidah keputusan tersebut menunjukkan bahwa calon penerima beasiswa dengan IPK tinggi langsung diloloskan tanpa memandang kondisi ekonomi maupun keaktifan organisasi. Namun bagi mahasiswa dengan IPK sedang, bantuan beasiswa diprioritaskan bagi mereka yang berasal dari keluarga berpenghasilan rendah.
Gain Ratio: Keunggulan Algoritma C4.5 Dibandingkan ID3
Banyak peneliti mahasiswa menanyakan mengapa algoritma C4.5 lebih disukai daripada ID3 murni dalam penelitian skripsi. Jawaban fundamentalnya terletak pada mekanisme koreksi terhadap atribut bernilai unik (high-cardinality attributes).
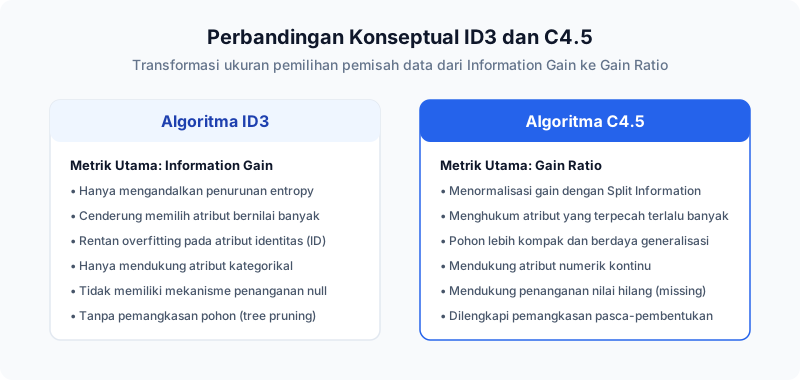
Perbedaan karakteristik pembentukan pohon keputusan pada algoritma ID3 dan algoritma C4.5. Sumber: diagram oleh Metodika.
Bayangkan jika dataset di atas memuat atribut Nomor Induk Mahasiswa (NIM). Karena setiap mahasiswa memiliki NIM yang berbeda, jika dihitung menggunakan Information Gain murni, setiap cabang NIM akan menghasilkan subset beranggotakan tepat satu data dengan entropy 0. Akibatnya, algoritma ID3 akan secara keliru menobatkan NIM sebagai simpul akar terbaik dengan Information Gain maksimal, padahal NIM sama sekali tidak memiliki daya prediksi terhadap mahasiswa baru.
Algoritma C4.5 mengatasi kelemahan fatal tersebut melalui Split Information. Atribut dengan banyak cabang akan menghasilkan nilai Split Information yang sangat besar, sehingga membagi nilai gain menjadi sangat kecil pada Gain Ratio. Selain itu, C4.5 dilengkapi kemampuan menangani atribut numerik kontinu melalui penentuan ambang batas (thresholding) dan pemangkasan cabang (pruning) untuk mencegah *overfitting* pada data uji baru, melengkapi keragaman teknik klasifikasi seperti pada analisis K-Nearest Neighbor.
Untuk atribut numerik kontinu seperti nilai IPK riil (misalnya 3,45 atau 3,80), C4.5 mengurutkan data sampel dari kecil ke besar, lalu mengevaluasi titik tengah antara dua nilai berurutan sebagai calon nilai ambang (cut point). Setiap calon ambang diuji perolehan gain rationya untuk membagi data menjadi dua kelompok biner: kurang dari ambang batas dan lebih dari atau sama dengan ambang batas. Mekanisme dinamis ini menjadikan C4.5 jauh lebih adaptif saat diterapkan pada kasus dunia nyata tanpa perlu melakukan diskritisasi manual yang kaku sebelum pemodelan dimulai.
Dari Hitungan Manual ke Program
Setelah memahami mekanika penentuan simpul akar secara manual, Anda dapat mengimplementasikannya ke dalam bahasa pemrograman seperti Python menggunakan pustaka scikit-learn. Parameter kriteria diatur ke nilai entropy agar menyerupai perhitungan teori informasi:
from sklearn.tree import DecisionTreeClassifier
import pandas as pd
data = pd.DataFrame({'IPK': [1,1,1,0,0,0], 'Penghasilan': [0,1,0,0,1,1], 'Organisasi': [1,1,0,1,1,0]})
y = [1, 1, 1, 1, 0, 0]
model = DecisionTreeClassifier(criterion='entropy', random_state=42)
model.fit(data, y)
print('Fitur akar:', data.columns[model.tree_.feature[0]])
Potongan kode di atas merepresentasikan enam baris data contoh yang telah kita hitung secara manual. Saat baris program dieksekusi, algoritma scikit-learn secara otomatis memilih fitur IPK sebagai indeks akar pertama, membuktikan konsistensi antara hitungan manual dan komputasi mesin.
Dalam penyusunan skripsi atau artikel jurnal, menyajikan perbandingan antara hitungan manual berskala kecil dan implementasi program merupakan nilai tambah yang sangat dihargai oleh dosen penguji. Bukti ini menunjukkan bahwa Anda memahami logika matematis terdalam dari algoritma yang Anda pakai, dan tidak sekadar menjalankan baris perintah pustaka secara mekanis tanpa mengerti proses di balik layar.
Bagi Anda yang sedang menyelesaikan skripsi atau riset machine learning dan memerlukan implementasi kode lengkap yang terstruktur, silakan kunjungi layanan Source Code Penelitian AI kami.
Referensi
- Quinlan, J. R. (1993). C4.5: Programs for Machine Learning. Morgan Kaufmann Publishers.
- Han, J., Kamber, M., & Pei, J. (2012). Data Mining: Concepts and Techniques (3rd ed.). Morgan Kaufmann.
Gambar sampul: Markus Spiske, commons.wikimedia.org, lisensi CC0.
Bagikan artikel ini
Komentar
Belum ada komentar. Jadilah yang pertama berdiskusi.