K-Means Clustering: Mengelompokkan Data dengan Hitungan Manual Iterasi demi Iterasi
Panduan lengkap k-means perhitungan manual dengan jarak Euclidean, pembaruan centroid iterasi demi iterasi, hingga evaluasi metode elbow untuk skripsi.
Oleh Ade Taopik Hidayatuloh, S.Kom., M.Kom. 13 menit baca
Daftar isi
- Konsep Dasar Pengelompokan Data dan Penentuan Centroid K-Means
- Studi Kasus K-Means Perhitungan Manual: Enam Data dan Dua Klaster
- Iterasi Pertama dan Kedua: Menghitung Jarak hingga Titik Konvergensi
- Kalkulasi Jarak dan Uji Konvergensi pada Iterasi Kedua
- Menentukan Jumlah Klaster Optimal Menggunakan Metode Elbow
- Perbandingan K-Means dengan Algoritma Machine Learning Lainnya
- Dari Hitungan Manual ke Program
- Referensi
Banyak mahasiswa program studi informatika atau sistem informasi yang memilih topik pengelompokan data untuk penelitian skripsi mereka, tetapi langsung bingung saat dosen penguji meminta pembuktian matematis di papan tulis. Menjalankan fungsi bawaan seperti KMeans() dari pustaka Scikit-Learn di Python memang bisa diselesaikan dalam lima baris kode, namun memahami bagaimana posisi titik pusat berpindah pada setiap putaran menuntut pemahaman terhadap logika dasarnya. Melalui panduan k-means perhitungan manual ini, kita akan membongkar seluruh mekanisme kalkulasi jarak, pengelompokan anggota, hingga titik konvergensi tercapai secara transparan.
K-Means merupakan salah satu algoritma pembelajaran tanpa pengawasan (unsupervised learning) paling populer di dunia sains data. Berbeda dengan metode klasifikasi terawasi seperti pada pembahasan K-Nearest Neighbor untuk Analisis Kepuasan Pengguna yang membutuhkan label target sejak awal, k-means bekerja mandiri menemukan pola kemiripan alami di antara sekumpulan data. Algoritma ini mempartisi \(N\) buah objek data ke dalam \(k\) kelompok (klaster), di mana setiap objek dimasukkan ke dalam kelompok dengan titik tengah terdekat.
Konsep Dasar Pengelompokan Data dan Penentuan Centroid K-Means
Inti filosofi dari algoritma k-means berputar pada konsep centroid, yaitu titik pusat koordinat yang mewakili rata-rata posisi seluruh objek di dalam sebuah klaster. Dalam bidang akademik, tujuan utama dari pengelompokan adalah memaksimalkan kesamaan internal di dalam satu klaster (high intra-cluster similarity) sekaligus memaksimalkan perbedaan antarklaster yang berlainan (low inter-cluster similarity). Semakin rapat titik-titik data di sekitar titik pusatnya, semakin kompak kualitas kelompok yang terbentuk.
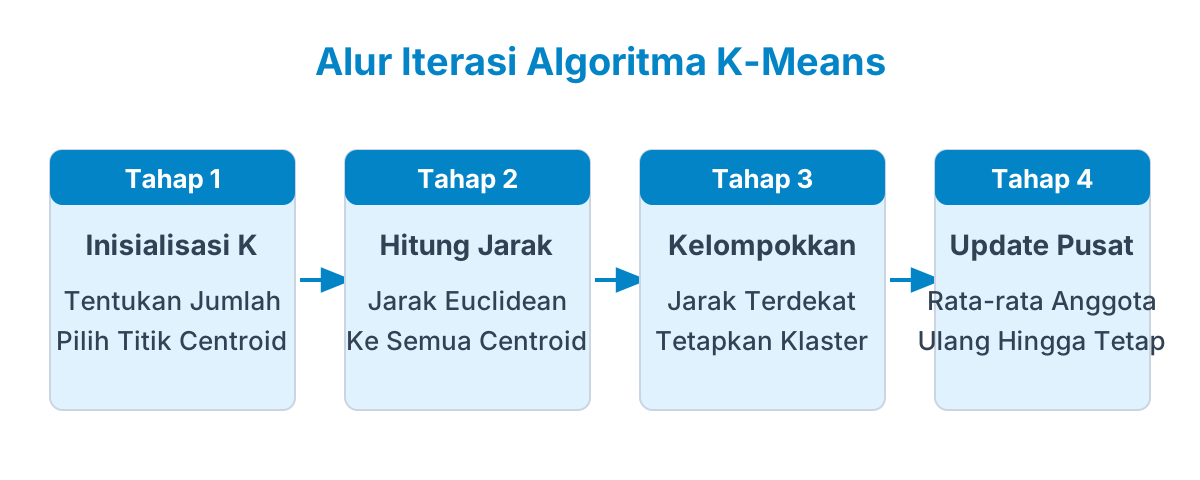
Alur tahapan iterasi algoritma k-means dari inisialisasi sampai konvergen. Sumber: diagram oleh Metodika.
Secara umum, siklus kerja algoritma k-means mengikuti serangkaian tahapan terstruktur yang berulang sampai tidak ada lagi perubahan yang signifikan pada keanggotaan kelompok data:
- Menentukan nilai k: Peneliti menetapkan di awal berapa jumlah kelompok yang ingin dibentuk berdasarkan telaah pustaka atau kebutuhan analisis praktis di lapangan.
- Menginisialisasi centroid awal: Memilih \(k\) titik koordinat acak dari kumpulan data atau menentukan titik koordinat awal tertentu sebagai pusat klaster generasi pertama.
- Menghitung jarak objek ke setiap centroid: Mengukur jarak geometris setiap baris data terhadap semua centroid yang aktif menggunakan formula jarak Euclidean.
- Alokasi anggota klaster: Setiap objek data ditempatkan ke klaster yang memiliki nilai jarak terkecil atau terdekat dengannya.
- Memperbarui posisi centroid: Menghitung ulang rata-rata nilai koordinat atribut dari semua objek data yang berhasil terhimpun di masing-masing klaster.
- Evaluasi kondisi berhenti: Memeriksa apakah posisi koordinat titik pusat masih bergeser atau keanggotaan klaster mengalami perubahan. Jika keanggotaan sudah stabil persis seperti iterasi sebelumnya, algoritma dinyatakan konvergen dan proses dihentikan.
Salah satu jebakan yang sering membuat mahasiswa ditegur saat sidang proposal adalah kesalahan dalam memilih titik pusat awal secara sembarangan. Pemilihan centroid awal yang kurang beruntung dapat menjebak algoritma pada nilai optimum lokal (local optima), sehingga hasil pengelompokan akhir menjadi bias. Di lingkungan ilmiah profesional, pendekatan seperti K-Means++ sering dipasang untuk memastikan jarak antartitik awal tersebar secara proporsional.
Studi Kasus K-Means Perhitungan Manual: Enam Data dan Dua Klaster
Agar simulasi matematis ini mudah dipahami dan bisa Anda verifikasi sendiri menggunakan kalkulator sains atau lembar sebar, kita gunakan studi kasus sederhana pada data evaluasi kinerja pelayanan Toko Retail Berkah (contoh). Kita memiliki 6 data responden (dinotasikan \(D_1\) sampai \(D_6\)) dengan 2 atribut pengukuran berskala 1 sampai 10, yaitu Atribut \(X\) (frekuensi transaksi bulanan) dan Atribut \(Y\) (skor kepuasan pelanggan). Target kita adalah mengelompokkan keenam pelanggan tersebut ke dalam \(k = 2\) klaster.
| Titik Data | Nama Responden (contoh) | Atribut X (Transaksi) | Atribut Y (Kepuasan) |
|---|---|---|---|
| \(D_1\) | Pelanggan Alpha | 1 | 1 |
| \(D_2\) | Pelanggan Beta | 2 | 1 |
| \(D_3\) | Pelanggan Gamma | 4 | 3 |
| \(D_4\) | Pelanggan Delta | 5 | 4 |
| \(D_5\) | Pelanggan Epsilon | 1 | 2 |
| \(D_6\) | Pelanggan Zeta | 4 | 5 |
Untuk memulai perhitungan manual, kita tentukan 2 titik centroid awal secara terencana. Kita tetapkan koordinat responden \(D_1\) sebagai Centroid 1 (\(C_1\)) dan responden \(D_4\) sebagai Centroid 2 (\(C_2\)):
- Centroid 1 (\(C_1\)): koordinat \((1, 1)\)
- Centroid 2 (\(C_2\)): koordinat \((5, 4)\)
Jarak antara setiap titik data dengan titik pusat klaster diukur menggunakan jarak Euclidean (*Euclidean distance*), yang dirumuskan secara matematis sebagai berikut:
\[ d(p, q) = \sqrt{\sum_{i=1}^{n} (p_i - q_i)^2} \]
dengan \(d(p, q)\) adalah nilai jarak Euclidean antara titik data \(p\) dan titik pusat \(q\), \(p_i\) menyatakan nilai atribut ke-\(i\) pada titik data, \(q_i\) menyatakan nilai atribut ke-\(i\) pada titik pusat centroid, dan \(n\) adalah banyaknya dimensi atribut yang dianalisis (dalam contoh ini \(n = 2\)).
Iterasi Pertama dan Kedua: Menghitung Jarak hingga Titik Konvergensi
Kini kita masuki proses komputasi riil. Pada iterasi pertama, seluruh data dihitung jaraknya terhadap \(C_1(1, 1)\) dan \(C_2(5, 4)\). Perhatikan contoh substitusi angka berikut untuk melihat cara kerja rumus jarak Euclidean:
- Jarak \(D_1(1, 1)\) ke \(C_1(1, 1)\): \(\sqrt{(1 - 1)^2 + (1 - 1)^2} = \sqrt{0 + 0} = 0{,}0000\)
- Jarak \(D_1(1, 1)\) ke \(C_2(5, 4)\): \(\sqrt{(1 - 5)^2 + (1 - 4)^2} = \sqrt{(-4)^2 + (-3)^2} = \sqrt{16 + 9} = \sqrt{25} = 5{,}0000\)
- Jarak \(D_3(4, 3)\) ke \(C_1(1, 1)\): \(\sqrt{(4 - 1)^2 + (3 - 1)^2} = \sqrt{3^2 + 2^2} = \sqrt{9 + 4} = \sqrt{13} \approx 3{,}6056\)
- Jarak \(D_3(4, 3)\) ke \(C_2(5, 4)\): \(\sqrt{(4 - 5)^2 + (3 - 4)^2} = \sqrt{(-1)^2 + (-1)^2} = \sqrt{1 + 1} = \sqrt{2} \approx 1{,}4142\)
Dengan menerapkan langkah perhitungan yang sama pada responden lainnya, seluruh jarak Euclidean dirangkum pada matriks jarak iterasi pertama di bawah ini:
| Titik Data | Jarak ke C1 (1, 1) | Jarak ke C2 (5, 4) | Jarak Terdekat | Klaster Terpilih |
|---|---|---|---|---|
| \(D_1\) | \(0{,}0000\) | \(5{,}0000\) | \(0{,}0000\) | Klaster 1 |
| \(D_2\) | \(1{,}0000\) | \(4{,}2426\) | \(1{,}0000\) | Klaster 1 |
| \(D_3\) | \(3{,}6056\) | \(1{,}4142\) | \(1{,}4142\) | Klaster 2 |
| \(D_4\) | \(5{,}0000\) | \(0{,}0000\) | \(0{,}0000\) | Klaster 2 |
| \(D_5\) | \(1{,}0000\) | \(4{,}4721\) | \(1{,}0000\) | Klaster 1 |
| \(D_6\) | \(5{,}0000\) | \(1{,}4142\) | \(1{,}4142\) | Klaster 2 |
Berdasarkan tabel di atas, Klaster 1 beranggotakan \(\{D_1, D_2, D_5\}\) dan Klaster 2 beranggotakan \(\{D_3, D_4, D_6\}\). Karena keanggotaan baru terbentuk, kita wajib menghitung titik pusat baru (koordinat centroid baru) berdasarkan rata-rata aritmetika anggota masing-masing klaster.
Rumus pembaruan koordinat centroid dinyatakan sebagai berikut:
\[ \mu_k = \frac{1}{|S_k|} \sum_{x \in S_k} x \]
dengan \(\mu_k\) adalah koordinat centroid baru untuk klaster \(k\), \(S_k\) adalah himpunan objek data yang tergabung dalam klaster \(k\), dan \(|S_k|\) adalah total banyaknya anggota di dalam klaster tersebut.
Berikut kalkulasi titik koordinat baru untuk Centroid 1 (\(C_1'\)):
- Nilai rata-rata atribut \(X\): \(\frac{1 + 2 + 1}{3} = \frac{4}{3} \approx 1{,}3333\)
- Nilai rata-rata atribut \(Y\): \(\frac{1 + 1 + 2}{3} = \frac{4}{3} \approx 1{,}3333\)
- Maka centroid baru \(C_1' = (1{,}3333; 1{,}3333)\)
Berikut kalkulasi titik koordinat baru untuk Centroid 2 (\(C_2'\)):
- Nilai rata-rata atribut \(X\): \(\frac{4 + 5 + 4}{3} = \frac{13}{3} \approx 4{,}3333\)
- Nilai rata-rata atribut \(Y\): \(\frac{3 + 4 + 5}{3} = \frac{12}{3} = 4{,}0000\)
- Maka centroid baru \(C_2' = (4{,}3333; 4{,}0000)\)
Kalkulasi Jarak dan Uji Konvergensi pada Iterasi Kedua
Pada iterasi kedua, kita menghitung kembali jarak setiap objek data terhadap koordinat centroid yang sudah diperbarui, yakni \(C_1'(1{,}3333; 1{,}3333)\) dan \(C_2'(4{,}3333; 4{,}0000)\). Simak contoh perhitungannya berikut ini:
- Jarak \(D_1(1, 1)\) ke \(C_1'\): \(\sqrt{(1 - 1{,}3333)^2 + (1 - 1{,}3333)^2} = \sqrt{(-0{,}3333)^2 + (-0{,}3333)^2} = \sqrt{0{,}1111 + 0{,}1111} \approx 0{,}4714\)
- Jarak \(D_1(1, 1)\) ke \(C_2'\): \(\sqrt{(1 - 4{,}3333)^2 + (1 - 4{,}0000)^2} = \sqrt{(-3{,}3333)^2 + (-3{,}0000)^2} = \sqrt{11{,}1111 + 9{,}0000} \approx 4{,}4845\)
- Jarak \(D_4(5, 4)\) ke \(C_1'\): \(\sqrt{(5 - 1{,}3333)^2 + (4 - 1{,}3333)^2} = \sqrt{(3{,}6667)^2 + (2{,}6667)^2} = \sqrt{13{,}4444 + 7{,}1111} \approx 4{,}5338\)
- Jarak \(D_4(5, 4)\) ke \(C_2'\): \(\sqrt{(5 - 4{,}3333)^2 + (4 - 4{,}0000)^2} = \sqrt{(0{,}6667)^2 + 0} = \sqrt{0{,}4444} \approx 0{,}6667\)
Kita susun seluruh hasil perbandingan jarak iterasi kedua ke dalam tabel alokasi:
| Titik Data | Jarak ke C1' (1,3333; 1,3333) | Jarak ke C2' (4,3333; 4,0000) | Jarak Terdekat | Klaster Terpilih |
|---|---|---|---|---|
| \(D_1\) | \(0{,}4714\) | \(4{,}4845\) | \(0{,}4714\) | Klaster 1 |
| \(D_2\) | \(0{,}7454\) | \(3{,}8006\) | \(0{,}7454\) | Klaster 1 |
| \(D_3\) | \(3{,}1447\) | \(1{,}0541\) | \(1{,}0541\) | Klaster 2 |
| \(D_4\) | \(4{,}5338\) | \(0{,}6667\) | \(0{,}6667\) | Klaster 2 |
| \(D_5\) | \(0{,}7454\) | \(3{,}8873\) | \(0{,}7454\) | Klaster 1 |
| \(D_6\) | \(4{,}5338\) | \(1{,}0541\) | \(1{,}0541\) | Klaster 2 |
Perhatikan kolom klaster terpilih pada tabel iterasi kedua. Titik \(D_1, D_2, D_5\) tetap berada di Klaster 1, sedangkan titik \(D_3, D_4, D_6\) tetap bertahan di Klaster 2. Karena tidak ada satu pun anggota data yang berpindah kelompok antara iterasi pertama dan iterasi kedua, maka posisi centroid tidak akan mengalami pergeseran lagi. Dengan demikian, algoritma dinyatakan telah mencapai titik konvergen dan proses perulangan k-means resmi selesai pada putaran kedua.
ulangi
  hitung jarak setiap data ke seluruh centroid
  kelompokkan data ke centroid terdekat
  hitung posisi rata-rata centroid baru
sampai posisi centroid tidak berubah lagi
Keterangan: Potongan pseudocode di atas merupakan logika inti algoritma k-means, bukan program lengkap siap jalan.
Kalau data penelitian Anda memiliki ribuan baris dengan belasan dimensi variabel, perhitungan matriks jarak manual seperti ini tentu memakan waktu panjang dan rawan kesalahan hitung jika tidak dibantu skrip pemrograman terstruktur.
Menentukan Jumlah Klaster Optimal Menggunakan Metode Elbow
Pertanyaan klasik yang hampir pasti dilontarkan dewan penguji skripsi saat Anda mengajukan judul bertopik k-means adalah: "Dari mana Anda tahu bahwa jumlah klaster harus dua atau tiga? Mengapa bukan empat?" Menjawab pertanyaan ini hanya dengan alasan intuisi atau tebakan pribadi akan langsung menurunkan bobot ilmiah skripsi Anda. Salah satu metode matematis paling terpercaya untuk menentukan nilai \(k\) terbaik adalah Metode Elbow (Elbow Method).
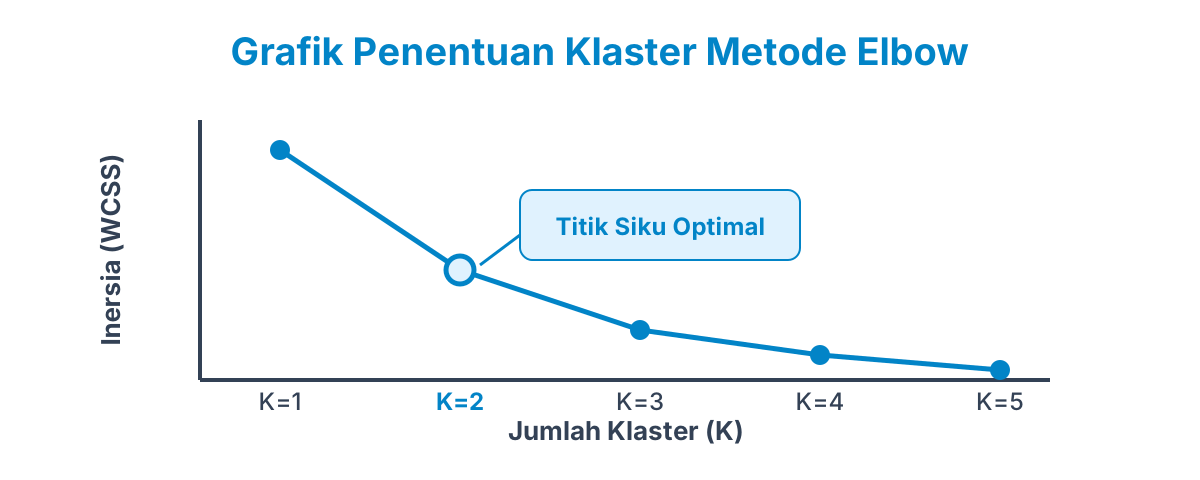
Grafik elbow method menunjukkan titik siku optimal pada k = 3. Sumber: diagram oleh Metodika.
Metode elbow bekerja dengan mengevaluasi nilai Sum of Squared Errors (SSE) atau inersia dari klaster untuk berbagai variasi nilai \(k\) (misalnya menguji \(k = 1\) hingga \(k = 8\)). Formula SSE menghitung total kuadrat jarak antara setiap titik data dengan titik pusat klaster yang menaunginya:
\[ \text{SSE} = \sum_{k=1}^{K} \sum_{x \in S_k} \| x - \mu_k \|^2 \]
dengan \(K\) adalah total jumlah klaster yang diuji, \(S_k\) adalah himpunan objek anggota klaster \(k\), \(x\) adalah vektor nilai data, dan \(\mu_k\) adalah vektor posisi titik pusat centroid klaster \(k\).
Secara matematis, semakin besar nilai \(k\) yang kita gunakan, nilai SSE pasti akan terus mengecil. Bahkan jika kita membuat nilai \(k\) sama persis dengan total jumlah baris data, nilai SSE akan menjadi nol karena setiap data menjadi pusat bagi dirinya sendiri. Namun, kondisi itu jelas tidak bermakna bagi analisis pengelompokan. Yang kita cari bukanlah SSE terendah secara mutlak, melainkan titik di mana penurunan SSE mulai melambat drastis sehingga kurva membentuk sudut siku-siku (menyerupai siku tangan manusia atau elbow).
Pada grafik hasil pengujian metode elbow, titik pembelokan siku itulah yang dipilih sebagai jumlah klaster paling optimal. Pada titik tersebut, penambahan jumlah klaster baru tidak lagi memberikan peningkatan kualitas pemisahan data yang sepadan dengan bertambahnya kompleksitas model penelitian Anda.
Perbandingan K-Means dengan Algoritma Machine Learning Lainnya
Banyak peneliti pemula sering tertukar antara algoritma k-means dan k-nearest neighbor (KNN) semata-mata karena keduanya memiliki huruf awalan \(k\) dan sama-sama memanfaatkan formula jarak Euclidean. Padahal, paradigma komputasi kedua metode ini berada pada ranah pembelajaran mesin yang berlawanan arah.
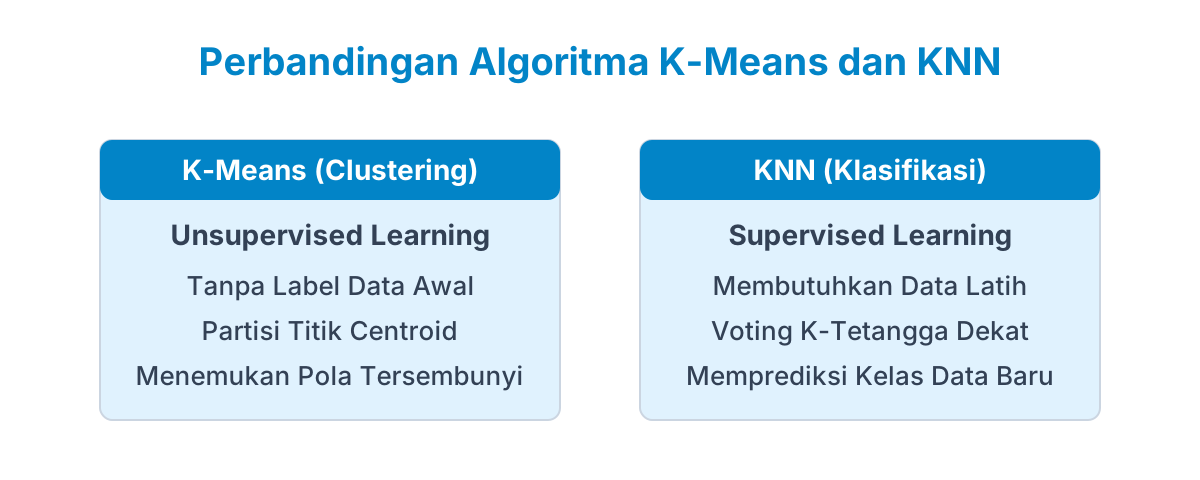
Perbandingan karakteristik algoritma k-means dan k-nearest neighbor. Sumber: diagram oleh Metodika.
Tabel berikut menyajikan ringkasan perbedaan fundamental antara k-means, k-nearest neighbor, dan metode probabilitas seperti yang dibahas pada ulasan Naive Bayes untuk Prediksi Kelulusan:
| Dimensi Karakteristik | K-Means Clustering | K-Nearest Neighbor (KNN) | Naive Bayes Classifier |
|---|---|---|---|
| Paradigma Pembelajaran | Unsupervised Learning (tanpa label kelas target) | Supervised Learning (membutuhkan label kelas acuan) | Supervised Learning (berbasis probabilitas kelas) |
| Peran Parameter k | Menentukan total jumlah kelompok klaster yang dibentuk | Menentukan banyaknya tetangga terdekat yang memberi suara | Tidak menggunakan parameter k |
| Basis Komputasi | Pergeseran titik pusat massa koordinat (centroid) | Pencarian objek data latih paling mirip di ruang vektor | Teorema probabilitas bersyarat Thomas Bayes |
| Fase Pelatihan Model | Iteratif hingga posisi titik centroid konvergen | Lazy learning (tidak ada fase pelatihan eksplisit) | Menghitung tabel frekuensi dan probabilitas data |
| Sensitivitas Outlier | Tinggi, titik ekstrem dapat menggeser posisi centroid | Sedang, dipengaruhi oleh persebaran tetangga terdekat | Rendah terhadap outlier jarak nilai kontinu |
Selain perbedaan struktural dengan algoritma terawasi di atas, Anda juga perlu memahami batasan operasional k-means saat menyusun Bab II skripsi. Algoritma k-means memiliki asumsi bahwa kelompok data yang terbentuk cenderung berbentuk bola simetris (spherical) dengan ukuran seimbang. Jika data riil di lapangan memiliki pola distribusi memanjang, berkelok-kelok, atau memiliki kepadatan yang sangat heterogen, algoritma pengelompokan berbasis densitas seperti DBSCAN sering kali menjadi alternatif pembanding yang lebih relevan.
Dari Hitungan Manual ke Program
Contoh perhitungan manual dengan enam baris data di atas dirancang untuk memberikan fondasi intuisi yang kokoh saat Anda duduk di hadapan dewan penguji skripsi. Akan tetapi, ketika Anda beralih mengimplementasikan algoritma k-means pada dataset penelitian skripsi yang memuat ratusan hingga ribuan responden pelanggan, ada beberapa tantangan teknis krusial yang harus diselesaikan di dalam kode program:
- Standardisasi Skala Data: Jika variabel \(X\) bernilai ratusan transaksi sedangkan variabel \(Y\) bernilai puluhan satuan kepuasan, variabel berangka besar akan mendominasi perhitungan jarak Euclidean secara tidak adil. Anda wajib melakukan penskalaan fitur menggunakan metode Z-score Standardization atau Min-Max Normalization sebelum data dimasukkan ke fungsi pengelompokan.
- Penanganan Titik Ekstrem (Outliers): Karena posisi centroid dihitung menggunakan rumus rata-rata aritmetika, satu data pencilan ekstrem bisa menarik posisi titik pusat klaster menjauh dari kumpulan data normal. Pembersihan data kotor atau penggunaan metode K-Medoids (PAM) bisa dipertimbangkan jika data memiliki tingkat derau tinggi.
- Pengujian K-Means++: Dalam implementasi kode program nyata menggunakan pustaka seperti Scikit-Learn di Python, inisialisasi titik pusat awal secara acak murni jarang digunakan. Gunakan opsi
init='k-means++'untuk mencegah algoritma terjebak pada titik optimum lokal yang buruk. - Penamaan Profil Klaster di Bab IV: Hasil luaran klaster dari algoritma komputer hanyalah berupa label kelompok numerik sederhana seperti Klaster 0 dan Klaster 1. Tugas Anda sebagai peneliti di Bab IV skripsi adalah menamai profil klaster tersebut secara ilmiah, misalnya menamai Klaster 1 sebagai "Kelompok Pelanggan Transaksi Rendah" dan Klaster 2 sebagai "Kelompok Pelanggan Loyalitas Tinggi" berdasarkan statistik deskriptif rata-rata atributnya.
- Validasi Klaster dengan Silhouette Score: Selain metode elbow, sertakan pengujian koefisien Silhouette Score atau indeks Davies-Bouldin untuk membuktikan kepada penguji bahwa jarak antarklaster sudah terpisah dengan tegas secara kuantitatif.
Bagi mahasiswa dan peneliti yang ingin membangun purwarupa aplikasi clustering cerdas, mengintegrasikan visualisasi scatter plot interaktif, atau membutuhkan asistensi komprehensif dalam menyusun kode komputasi kecerdasan buatan dari dataset lapangan hingga pembahasan tuntas di Bab IV naskah skripsi, Anda dapat memanfaatkan pendampingan teknis melalui layanan Source Code Penelitian AI bersama tim spesialis kami.
Referensi
MacQueen, J. (1967). Some methods for classification and analysis of multivariate observations. Proceedings of the Fifth Berkeley Symposium on Mathematical Statistics and Probability, 1(14), 281-297.
Jain, A. K. (2010). Data clustering: 50 years beyond K-means. Pattern Recognition Letters, 31(8), 651-666.
Gambar sampul: Lewis Ngugi, commons.wikimedia.org, lisensi CC0.
Bagikan artikel ini
Komentar
Belum ada komentar. Jadilah yang pertama berdiskusi.