K-Nearest Neighbor untuk Analisis Kepuasan Pengguna: Menghitung Jarak dan Menentukan Kelas secara Manual
Panduan langkah demi langkah algoritma K-Nearest Neighbor (KNN) untuk analisis kepuasan pengguna, konversi skala Likert, hitung manual Euclidean, dan evaluasi confusion matrix.
Oleh Ade Taopik Hidayatuloh, S.Kom., M.Kom. 11 menit baca
Daftar isi
- Prinsip Kerja Algoritma KNN Analisis Kepuasan dan Penentuan Nilai K
- Transformasi Data Kuesioner Skala Likert Menjadi Vektor Fitur
- Contoh Hitung Manual Langkah demi Langkah Jarak Euclidean dan Voting \(k = 3\)
- 1. Menghitung Jarak Euclidean dari Data Uji ke Setiap Data Latih
- 2. Pengurutan Jarak dan Voting Mayoritas (\(k = 3\))
- Membaca Akurasi dan Evaluasi Confusion Matrix
- Pentingnya Normalisasi Data Sebelum Perhitungan Jarak Geometris
- Empat Kesalahan Umum Mahasiswa Saat Menerapkan KNN pada Skripsi
- Dari Hitungan Manual ke Program
- Penutup
- Referensi
Dalam riset evaluasi sistem informasi, mengukur tingkat penerimaan pengguna merupakan tahapan penting untuk membuktikan keberhasilan perangkat lunak. Salah satu pendekatan pembelajaran mesin yang paling sering digunakan adalah algoritma KNN analisis kepuasan pengguna. Algoritma K-Nearest Neighbor (KNN) memiliki keunggulan pada kesederhanaan logika penentuan kelas berdasarkan kedekatan jarak fitur tanpa memerlukan proses pelatihan bobot model yang rumit.
Pada penelitian skripsi bidang informatika, mahasiswa sering membagikan kuesioner berskala Likert untuk mengukur kepuasan pengguna terhadap suatu aplikasi. Pertanyaan yang sering muncul di ruang sidang adalah bagaimana membuktikan bahwa model machine learning yang dibangun benar-benar mampu mengelompokkan pengguna ke dalam kategori Puas atau Tidak Puas secara akurat. Berbeda dengan model deep learning yang dibahas pada panduan klasifikasi gambar dengan CNN, KNN bekerja transparan karena setiap keputusan kelas dapat dilacak langsung dari perhitungan jarak geometris.
Artikel ini menyajikan panduan komprehensif mulai dari konsep kerja KNN, transformasi data kuesioner menjadi vektor fitur, simulasi perhitungan manual jarak Euclidean pada enam data latih, penentuan voting kelas dengan nilai k ganjil, hingga pembacaan metrik evaluasi pada confusion matrix.
Prinsip Kerja Algoritma KNN Analisis Kepuasan dan Penentuan Nilai K
K-Nearest Neighbor adalah algoritma supervised learning berbasis instans (instance-based learning). KNN tidak membangun fungsi diskriminan eksplisit selama fase pelatihan, melainkan menyimpan seluruh data latih di dalam memori. Ketika ada data uji baru yang masuk, KNN mengukur jarak antara titik data baru tersebut dengan seluruh data latih, memilih sejumlah k tetangga dengan jarak terdekat, lalu menentukan kelas mayoritas melalui voting suara.
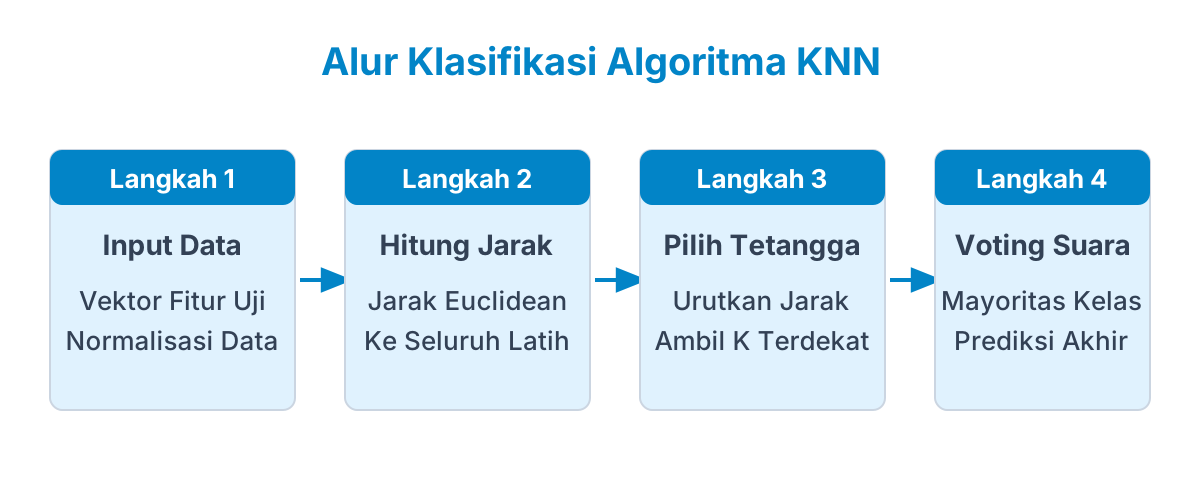
Tahapan pemrosesan data, perhitungan jarak, hingga voting kelas pada algoritma KNN. Sumber: diagram oleh Metodika.
Parameter paling penting dalam KNN adalah pemilihan nilai \(k\) (jumlah tetangga terdekat). Ada beberapa prinsip mendasar yang wajib Anda perhatikan saat menentukan nilai \(k\):
- Pilih Nilai Ganjil untuk Klasifikasi Biner: Pada klasifikasi dua kelas (misalnya Puas vs Tidak Puas), gunakan nilai k bernilai ganjil seperti \(k = 3\), \(k = 5\), atau \(k = 7\) untuk menghindari hasil imbang (tie) pada proses pemungutan suara mayoritas.
- Hindari Nilai \(k\) Terlalu Kecil: Nilai \(k = 1\) sangat sensitif terhadap data pencilan (outlier) dan derau (noise) pada kuesioner, sehingga model rentan mengalami overfitting.
- Hindari Nilai \(k\) Terlalu Besar: Nilai \(k\) yang terlalu besar akan mengaburkan batas antarkelas karena tetangga yang berada di kelas lain yang jauh ikut terhitung dalam voting, sehingga menyebabkan underfitting.
Transformasi Data Kuesioner Skala Likert Menjadi Vektor Fitur
Dalam survei kepuasan, responden umumnya menjawab butir pernyataan dengan skala Likert 1 sampai 5 (1 = Sangat Tidak Setuju, hingga 5 = Sangat Setuju). Agar dapat dihitung oleh algoritma KNN, skor butir pertanyaan dikelompokkan ke dalam dimensi variabel yang terstandar.
Sebagai ilustrasi studi kasus, kita menguji kepuasan pengguna pada Aplikasi Layanan Mahasiswa Terpadu (nama samaran) di Kampus Z (nama samaran). Kuesioner dirangkum ke dalam dua atribut fitur utama:
- X1 (Kualitas Antarmuka dan Kecepatan): Rata-rata skor kemudahan navigasi dan responsivitas aplikasi (skala 1 sampai 5).
- X2 (Ketepatan Informasi dan Keandalan): Rata-rata skor keakuratan data dan kelengkapan fitur layanan (skala 1 sampai 5).
- Y (Label Kelas Kepuasan): Ditetapkan secara objektif menjadi dua kelas: 'Puas' dan 'Tidak Puas'.
Contoh Hitung Manual Langkah demi Langkah Jarak Euclidean dan Voting \(k = 3\)
Berikut adalah tabel dataset yang terdiri dari 6 data latih (\(D_1\) sampai \(D_6\)) yang telah memiliki label kelas pasti, serta 1 data uji baru (\(D_{\text{uji}}\)) yang ingin diprediksi status kepuasannya:
| Kode Responden | Nama / ID Responden | \(X_1\) (Antarmuka) | \(X_2\) (Keandalan) | Label Aktual |
|---|---|---|---|---|
| \(D_1\) | Responden A (nama samaran) | 4 | 4 | Puas |
| \(D_2\) | Responden B (nama samaran) | 5 | 5 | Puas |
| \(D_3\) | Responden C (nama samaran) | 1 | 2 | Tidak Puas |
| \(D_4\) | Responden D (nama samaran) | 2 | 2 | Tidak Puas |
| \(D_5\) | Responden E (nama samaran) | 4 | 3 | Puas |
| \(D_6\) | Responden F (nama samaran) | 2 | 3 | Tidak Puas |
| \(D_{\text{uji}}\) | Responden Uji (nama samaran) | 4 | 5 | ? (Akan Diprediksi) |
1. Menghitung Jarak Euclidean dari Data Uji ke Setiap Data Latih
Rumus jarak Euclidean antara titik data latih \(x\) dan titik data uji \(u\) dihitung dengan persamaan berikut:
\[ d(x, u) = \sqrt{\sum_{j=1}^{p} (x_j - u_j)^{2}} \]
dengan \(d(x, u)\) adalah jarak Euclidean, \(x_j\) adalah nilai atribut ke-\(j\) pada data latih, \(u_j\) adalah nilai atribut ke-\(j\) pada data uji, dan \(p\) adalah jumlah dimensi atribut. Berikut rincian perhitungan jarak data uji \(D_{\text{uji}} (4, 5)\) ke setiap data latih:
- Jarak ke \(D_1 (4, 4)\): \(d = \sqrt{(4 - 4)^{2} + (4 - 5)^{2}} = \sqrt{0 + 1} = \sqrt{1} = 1{,}000\)
- Jarak ke \(D_2 (5, 5)\): \(d = \sqrt{(5 - 4)^{2} + (5 - 5)^{2}} = \sqrt{1 + 0} = \sqrt{1} = 1{,}000\)
- Jarak ke \(D_5 (4, 3)\): \(d = \sqrt{(4 - 4)^{2} + (3 - 5)^{2}} = \sqrt{0 + 4} = \sqrt{4} = 2{,}000\)
- Jarak ke \(D_6 (2, 3)\): \(d = \sqrt{(2 - 4)^{2} + (3 - 5)^{2}} = \sqrt{4 + 4} = \sqrt{8} \approx 2{,}828\)
- Jarak ke \(D_4 (2, 2)\): \(d = \sqrt{(2 - 4)^{2} + (2 - 5)^{2}} = \sqrt{4 + 9} = \sqrt{13} \approx 3{,}606\)
- Jarak ke \(D_3 (1, 2)\): \(d = \sqrt{(1 - 4)^{2} + (2 - 5)^{2}} = \sqrt{9 + 9} = \sqrt{18} \approx 4{,}243\)
Menangani data kuesioner berskala ratusan responden serta melakukan tuning nilai k yang optimal pada validasi silang (cross-validation) biasanya kami dampingi secara teknis bersama klien.
2. Pengurutan Jarak dan Voting Mayoritas (\(k = 3\))
Setelah seluruh jarak Euclidean dihitung, langkah berikutnya adalah mengurutkan data dari jarak terkecil ke terbesar dan mengambil 3 tetangga terdekat (\(k = 3\)):
| Urutan Jarak | Kode Data Latih | Jarak Euclidean (\(d\)) | Kelas Tetangga | Masuk \(k=3\)? |
|---|---|---|---|---|
| 1 | \(D_1\) | \(1{,}000\) | Puas | Ya (Tetangga 1) |
| 2 | \(D_2\) | \(1{,}000\) | Puas | Ya (Tetangga 2) |
| 3 | \(D_5\) | \(2{,}000\) | Puas | Ya (Tetangga 3) |
| 4 | \(D_6\) | \(2{,}828\) | Tidak Puas | Tidak |
| 5 | \(D_4\) | \(3{,}606\) | Tidak Puas | Tidak |
| 6 | \(D_3\) | \(4{,}243\) | Tidak Puas | Tidak |
Dari 3 tetangga terdekat yang terpilih (\(D_1\), \(D_2\), dan \(D_5\)), seluruhnya memiliki kelas 'Puas' (3 suara Puas, 0 suara Tidak Puas). Dengan demikian, data uji \(D_{\text{uji}}\) secara mutlak diprediksi masuk ke dalam kategori Puas.
Membaca Akurasi dan Evaluasi Confusion Matrix
Setelah model mengklasifikasikan seluruh data uji, performa sistem dievaluasi menggunakan confusion matrix berukuran \(2 \times 2\). Confusion matrix memetakan perbandingan antara kelas aktual responden dan hasil prediksi model:
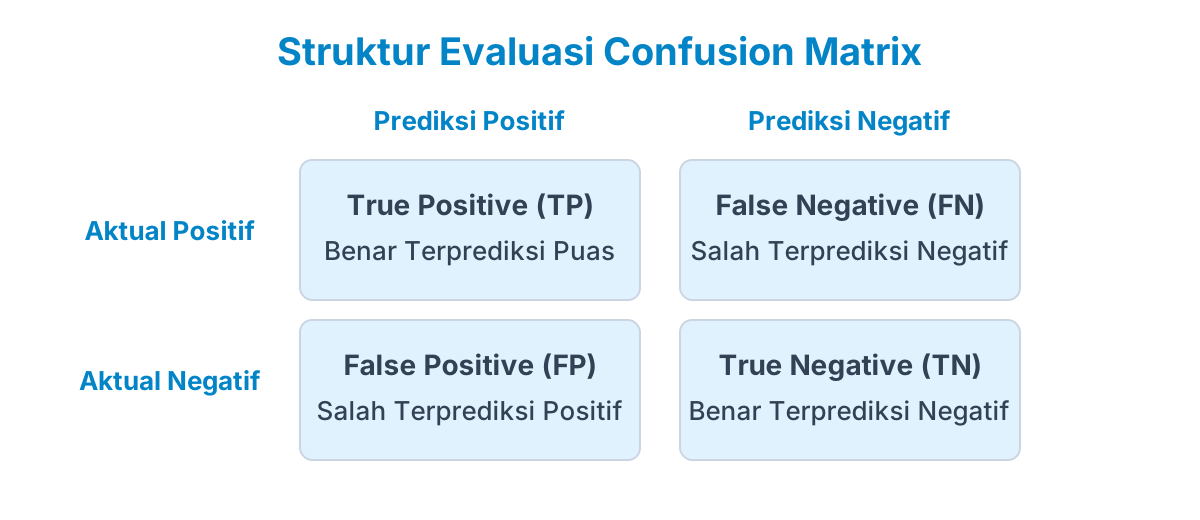
Pemetaan True Positive, False Positive, True Negative, dan False Negative pada evaluasi klasifikasi biner. Sumber: diagram oleh Metodika.
- True Positive (TP): Jumlah responden yang aktualnya Puas dan berhasil diprediksi Puas oleh sistem.
- True Negative (TN): Jumlah responden yang aktualnya Tidak Puas dan berhasil diprediksi Tidak Puas oleh sistem.
- False Positive (FP): Responden aktual Tidak Puas namun keliru diprediksi Puas oleh sistem.
- False Negative (FN): Responden aktual Puas namun keliru diprediksi Tidak Puas oleh sistem.
Dari keempat nilai tersebut, Anda dapat menghitung metrik evaluasi utama sebagai berikut:
\[ \text{Akurasi} = \frac{\mathrm{TP} + \mathrm{TN}}{\mathrm{TP} + \mathrm{TN} + \mathrm{FP} + \mathrm{FN}} \]
\[ \text{Presisi} = \frac{\mathrm{TP}}{\mathrm{TP} + \mathrm{FP}} \qquad \text{Recall} = \frac{\mathrm{TP}}{\mathrm{TP} + \mathrm{FN}} \]
dengan \(\mathrm{TP}\) adalah True Positive, \(\mathrm{TN}\) adalah True Negative, \(\mathrm{FP}\) adalah False Positive, dan \(\mathrm{FN}\) adalah False Negative.
Jika dataset kuesioner Anda memiliki jumlah responden yang tidak seimbang antara kelas puas dan tidak puas, selalu sertakan metrik Presisi dan Recall di samping angka Akurasi agar evaluasi penelitian Anda tidak bias.
Pentingnya Normalisasi Data Sebelum Perhitungan Jarak Geometris
Salah satu kelemahan paling mendasar yang kerap luput dari perhatian mahasiswa saat menguji KNN adalah sensitivitas jarak terhadap skala nilai atribut. Dalam contoh kuesioner di atas, seluruh fitur berada pada rentang skala Likert yang seragam yaitu 1 hingga 5. Namun, dalam banyak kasus penelitian skripsi nyata, fitur input sering kali menggabungkan variabel kuesioner dengan variabel demografis atau data log sistem, misalnya usia responden (rentang 18 sampai 60 tahun), pendapatan bulanan, atau frekuensi login aplikasi (rentang 1 sampai 150 kali per bulan).
Jika fitur dengan rentang nilai besar dihitung langsung bersama fitur berskala kecil tanpa standarisasi, selisih kuadrat pada fitur besar akan mendominasi seluruh nilai jarak Euclidean. Akibatnya, fitur kuesioner yang sebenarnya sangat menentukan kepuasan justru terabaikan karena perbedaannya tertelan oleh variasi angka pada fitur frekuensi login. Untuk mencegah bias komputasi tersebut, Anda wajib melakukan proses normalisasi data ke dalam rentang seragam \( [0, 1] \) menggunakan metode Min-Max Normalization berikut:
\[ x_{\text{norm}} = \frac{x - x_{\min}}{x_{\max} - x_{\min}} \]
dengan \(x\) adalah nilai data asli, \(x_{\min}\) adalah nilai terendah pada fitur tersebut, \(x_{\max}\) adalah nilai tertinggi, dan \(x_{\text{norm}}\) adalah nilai hasil normalisasi. Jika Anda terbiasa membaca perbandingan bobot pada analisis keputusan dengan metode eksponensial (MPE), prinsip kesetaraan skala pada KNN juga memiliki tujuan serupa, yaitu memastikan setiap variabel input diperlakukan secara proporsional sesuai kontribusi analitiknya.
Empat Kesalahan Umum Mahasiswa Saat Menerapkan KNN pada Skripsi
Berdasarkan catatan sidang skripsi di berbagai program studi informatika, ada empat kekeliruan berulang yang sering membuat mahasiswa kesulitan mempertahankan hasil penelitiannya:
1. Menggunakan Nilai \(k\) Genap pada Klasifikasi Dua Kelas: Memilih nilai \(k = 4\) atau \(k = 6\) pada klasifikasi biner Puas vs Tidak Puas sangat berisiko memunculkan kondisi seri ketika 2 tetangga memilih Puas dan 2 tetangga memilih Tidak Puas. Bila kondisi imbang ini terjadi, program komputer biasanya memilih kelas pertama berdasarkan indeks urutan abjad secara acak, yang tentu mengurangi validitas ilmiah keputusan model.
2. Menentukan Nilai \(k\) Hanya Berdasarkan Tebakan Tanpa Optimasi: Mahasiswa sering kali menetapkan nilai \(k = 3\) hanya karena mengikuti contoh tutorial tanpa melakukan eksperimen pengujian bertahap. Cara ilmiah yang benar adalah menguji rentang nilai \(k\) ganjil dari 1 sampai 15 menggunakan teknik K-Fold Cross Validation, lalu memilih nilai \(k\) yang menghasilkan skor akurasi rata-rata tertinggi.
3. Terkecoh Angka Akurasi Tinggi pada Dataset Tidak Seimbang: Apabila dari 100 responden terdapat 90 orang Puas dan hanya 10 orang Tidak Puas, model naif yang memprediksi seluruh responden sebagai Puas sekalipun akan menghasilkan angka akurasi \(90\%\). Namun model tersebut sebenarnya gagal mendeteksi ketidakpuasan sama sekali. Oleh karena itu, penguji skripsi selalu menuntut nilai Presisi, Recall, dan F1-Score di samping metrik akurasi murni.
4. Mengabaikan Waktu Komputasi saat Data Bertambah Besar: Karena KNN merupakan algoritma pemalas (lazy learner) yang menunda seluruh komputasi jarak hingga waktu kueri pengujian tiba, kompleksitas waktu pencarian tetangga akan meningkat drastis seiring bertambahnya jumlah data latih. Untuk proyek sistem berbasis web berskala besar, pertimbangkan penerapan struktur data pengindeksan spasial seperti KD-Tree atau Ball Tree.
Dari Hitungan Manual ke Program
Dalam simulasi di atas, kita hanya menghitung 6 data latih dan 1 data uji dengan 2 variabel. Namun, dalam aplikasi sistem nyata yang melibatkan ratusan responden dan puluhan butir instrumen, komputasi manual menjadi mustahil dilakukan.
Pada implementasi program sungguhan, Anda membutuhkan tahapan normalisasi data (seperti Min-Max Scaler atau Z-score Standardization) agar fitur dengan rentang nilai besar tidak mendominasi perhitungan jarak. Selain itu, Anda perlu menerapkan validasi silang (k-fold cross validation) untuk menemukan nilai \(k\) terbaik secara otomatis, serta mengintegrasikan basis data relasional untuk menyimpan histori penilaian kuesioner pengguna secara terstruktur.
import numpy as np
def hitung_jarak(data_latih, data_uji):
    return np.sqrt(np.sum((data_latih - data_uji) ** 2, axis=1))
def prediksi_knn(jarak, label, k=3):
    terdekat = np.argsort(jarak)[:k]
    return max(set(label[terdekat]), key=list(label[terdekat]).count)
Keterangan: Potongan kode di atas hanya menunjukkan implementasi logika inti perhitungan jarak dan pemilihan tetangga terdekat pada KNN, bukan keseluruhan sistem program aplikasi.
Penutup
K-Nearest Neighbor adalah algoritma klasifikasi yang tangguh dan sangat intuitif untuk analisis kepuasan pengguna. Melalui pemahaman yang kokoh atas cara kerja matematisnya dari rumus jarak Euclidean hingga confusion matrix, Anda dapat menyajikan pembahasan hasil penelitian yang mendalam dan meyakinkan di depan dewan penguji skripsi.
Bagi Anda yang sedang mengerjakan tugas akhir atau penelitian kecerdasan buatan dan membutuhkan source code algoritma klasifikasi siap pakai lengkap dengan pengujian akurasi untuk naskah Bab IV, layanan Source Code Penelitian AI kami siap mendampingi kebutuhan pemrograman Anda.
Referensi
Cover, T., & Hart, P. (1967). Nearest neighbor pattern classification. IEEE Transactions on Information Theory, 13(1), 21-27.
Han, J., Kamber, M., & Pei, J. (2012). Data Mining: Concepts and Techniques (3rd ed.). Waltham: Morgan Kaufmann.
Gambar sampul: Luis Llerena, commons.wikimedia.org, lisensi CC0.
Bagikan artikel ini
Komentar
Belum ada komentar. Jadilah yang pertama berdiskusi.