Membangun Model Klasifikasi Gambar dengan CNN untuk Skripsi: Panduan dari Data hingga Evaluasi
Panduan langkah demi langkah membangun model klasifikasi gambar dengan CNN dan transfer learning MobileNetV2 — mulai dari menyiapkan dataset, augmentasi, pelatihan dengan early stopping, hingga evaluasi yang layak dilaporkan di skripsi.
Oleh Ade Taopik Hidayatuloh, S.Kom., M.Kom. 8 menit baca
Daftar isi
- Apa itu CNN dan mengapa cocok untuk gambar
- Langkah 1: Menyiapkan dataset
- Struktur folder
- Berapa banyak gambar yang dibutuhkan?
- Membagi data latih, validasi, dan uji
- Langkah 2: Memuat data dan augmentasi
- Langkah 3: Membangun CNN dari nol
- Melatih dengan early stopping
- Langkah 4: Transfer learning untuk data terbatas
- Langkah 5: Evaluasi yang layak dilaporkan
- Langkah 6: Menyusun hasil di skripsi
- Penutup
Klasifikasi gambar adalah salah satu topik skripsi kecerdasan buatan yang paling sering dipilih mahasiswa informatika. Alasannya masuk akal: datanya mudah dikumpulkan, hasilnya mudah ditunjukkan, dan pustakanya sudah matang. Namun banyak skripsi tersendat bukan karena modelnya sulit, melainkan karena langkah-langkah di sekitar model — menyiapkan data, membagi data, memilih metrik, dan melaporkan hasil — dikerjakan terburu-buru.
Artikel ini membahas alur lengkapnya memakai contoh kasus klasifikasi jenis sampah ke dalam empat kelas: organik, plastik, kertas, dan logam. Contoh kode memakai Python dengan TensorFlow/Keras, tetapi prinsipnya berlaku untuk pustaka lain.
Apa itu CNN dan mengapa cocok untuk gambar
Convolutional Neural Network (CNN) adalah jaringan saraf yang dirancang untuk data berbentuk kisi, seperti piksel pada gambar. Alih-alih menghubungkan setiap piksel ke setiap neuron, CNN memakai filter kecil (misalnya 3×3) yang digeser ke seluruh gambar. Setiap filter belajar mengenali pola lokal: tepi, sudut, tekstur, lalu pada lapisan yang lebih dalam, bentuk yang lebih kompleks.
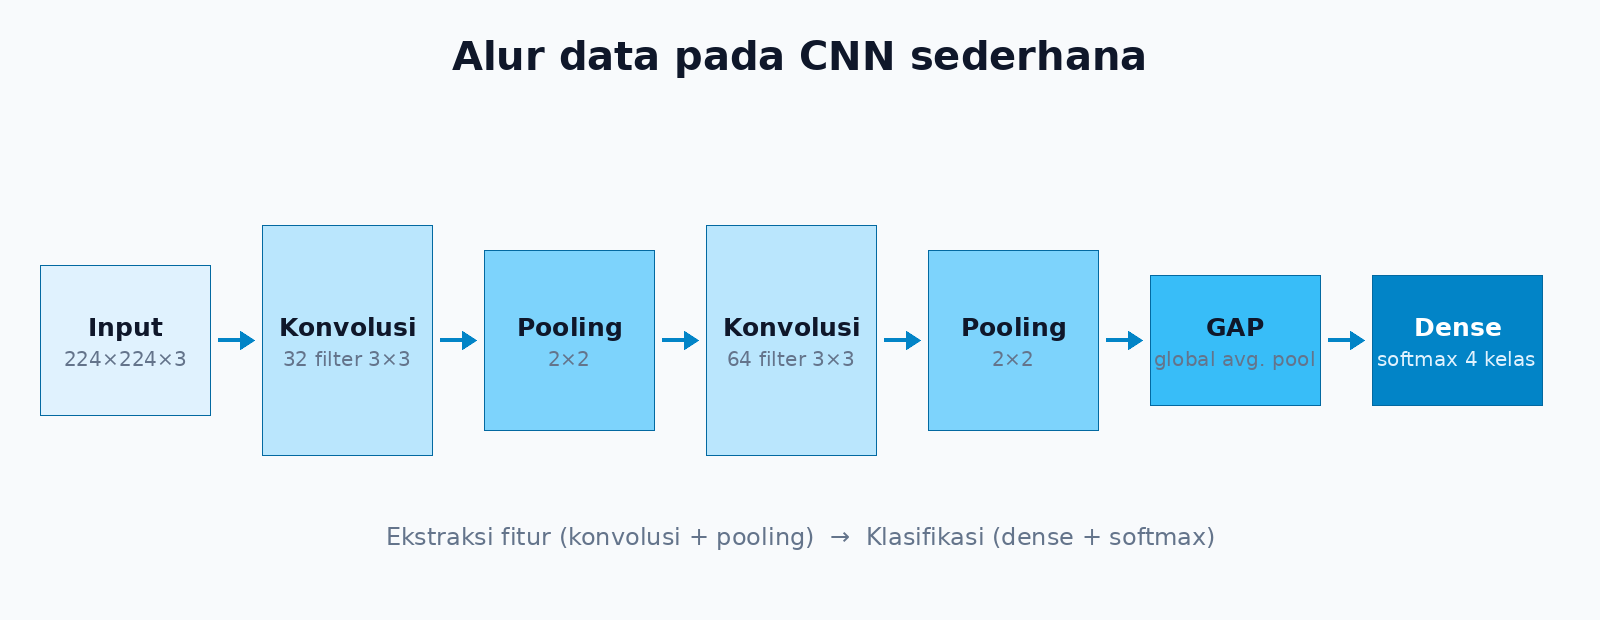
Gambar 1. Alur data pada CNN sederhana: bagian kiri mengekstraksi fitur, bagian kanan melakukan klasifikasi.
Ada tiga komponen utama yang perlu Anda pahami sebelum menulis Bab II:
Lapisan konvolusi — menghasilkan feature map dari filter yang dipelajari.
Lapisan pooling — memperkecil ukuran feature map (misalnya mengambil nilai maksimum tiap blok 2×2) sehingga komputasi lebih ringan dan model lebih tahan terhadap pergeseran kecil.
Lapisan dense dengan softmax — mengubah fitur menjadi probabilitas untuk tiap kelas.
Langkah 1: Menyiapkan dataset
Kualitas dataset menentukan batas atas kualitas model. Model terbaik pun tidak bisa memperbaiki label yang salah.
Struktur folder
Cara paling praktis adalah menyimpan gambar per kelas dalam folder terpisah. Pustaka seperti Keras bisa langsung membaca struktur ini dan memberi label sesuai nama folder.
dataset/
├── kertas/
│   ├── kertas_0001.jpg
│   └── ...
├── logam/
├── organik/
└── plastik/
Berapa banyak gambar yang dibutuhkan?
Tidak ada angka pasti, tetapi sebagai pegangan awal: usahakan minimal beberapa ratus gambar per kelas jika melatih dari nol, dan jumlah tiap kelas tidak timpang jauh. Jika data terbatas, gunakan transfer learning (dibahas di Langkah 4) — teknik ini sering memberi hasil baik dengan data yang jauh lebih sedikit.
Catat sumber setiap gambar dan lisensinya sejak awal. Penguji sering menanyakan asal data, dan menjawabnya belakangan jauh lebih sulit.
Membagi data latih, validasi, dan uji
Kesalahan paling umum dalam skripsi adalah mengevaluasi model memakai data yang sudah dilihat model saat pelatihan. Pisahkan data menjadi tiga bagian:
| Bagian | Proporsi umum | Fungsi |
|---|---|---|
| Latih (train) | 70% | Dipakai model untuk belajar. |
| Validasi (validation) | 15% | Memantau pelatihan dan memilih hiperparameter. |
| Uji (test) | 15% | Disimpan sampai akhir; hanya dipakai sekali untuk melaporkan hasil. |
Data uji sebaiknya dipisahkan ke folder sendiri sebelum eksperimen dimulai, lalu tidak disentuh sampai model final dipilih.
Langkah 2: Memuat data dan augmentasi
Keras menyediakan fungsi untuk memuat gambar langsung dari folder sekaligus membagi data latih dan validasi. Parameter seed wajib diisi agar pembagian sama di setiap percobaan — ini penting untuk reprodusibilitas.
import tensorflow as tf

UKURAN = (224, 224)
BATCH = 32

data_latih = tf.keras.utils.image_dataset_from_directory(
    "dataset/latih_validasi",
    validation_split=0.2,
    subset="training",
    seed=42,
    image_size=UKURAN,
    batch_size=BATCH,
)
data_validasi = tf.keras.utils.image_dataset_from_directory(
    "dataset/latih_validasi",
    validation_split=0.2,
    subset="validation",
    seed=42,
    image_size=UKURAN,
    batch_size=BATCH,
)
nama_kelas = data_latih.class_names
print(nama_kelas)  # ['kertas', 'logam', 'organik', 'plastik']
Augmentasi data membuat variasi gambar secara acak saat pelatihan — dibalik, diputar sedikit, diperbesar — sehingga model tidak sekadar menghafal. Augmentasi hanya aktif saat pelatihan, tidak saat prediksi.
from tensorflow.keras import layers

augmentasi = tf.keras.Sequential([
    layers.RandomFlip("horizontal"),
    layers.RandomRotation(0.1),
    layers.RandomZoom(0.1),
])
Langkah 3: Membangun CNN dari nol
Untuk memahami cara kerja CNN, mulailah dengan arsitektur kecil. Model ini cukup sebagai baseline — titik pembanding untuk model yang lebih canggih.
model = tf.keras.Sequential([
    layers.Input(shape=UKURAN + (3,)),
    augmentasi,
    layers.Rescaling(1.0 / 255),
    layers.Conv2D(32, 3, padding="same", activation="relu"),
    layers.MaxPooling2D(),
    layers.Conv2D(64, 3, padding="same", activation="relu"),
    layers.MaxPooling2D(),
    layers.Conv2D(128, 3, padding="same", activation="relu"),
    layers.MaxPooling2D(),
    layers.GlobalAveragePooling2D(),
    layers.Dropout(0.3),
    layers.Dense(len(nama_kelas), activation="softmax"),
])

model.compile(
    optimizer="adam",
    loss="sparse_categorical_crossentropy",
    metrics=["accuracy"],
)
model.summary()
Beberapa keputusan desain di atas yang layak dijelaskan di skripsi:
Rescaling(1.0 / 255)mengubah nilai piksel dari 0–255 menjadi 0–1 agar pelatihan stabil.GlobalAveragePooling2Ddipakai menggantikanFlattenuntuk mengurangi jumlah parameter secara drastis.Dropout(0.3)mematikan 30% neuron secara acak saat pelatihan untuk mengurangi overfitting.Loss
sparse_categorical_crossentropydipakai karena label berupa bilangan bulat (bawaanimage_dataset_from_directory).
Melatih dengan early stopping
Daripada menebak jumlah epoch, hentikan pelatihan otomatis ketika loss validasi tidak membaik lagi, lalu kembalikan bobot terbaik.
henti_dini = tf.keras.callbacks.EarlyStopping(
    monitor="val_loss",
    patience=5,
    restore_best_weights=True,
)

riwayat = model.fit(
    data_latih,
    validation_data=data_validasi,
    epochs=50,
    callbacks=[henti_dini],
)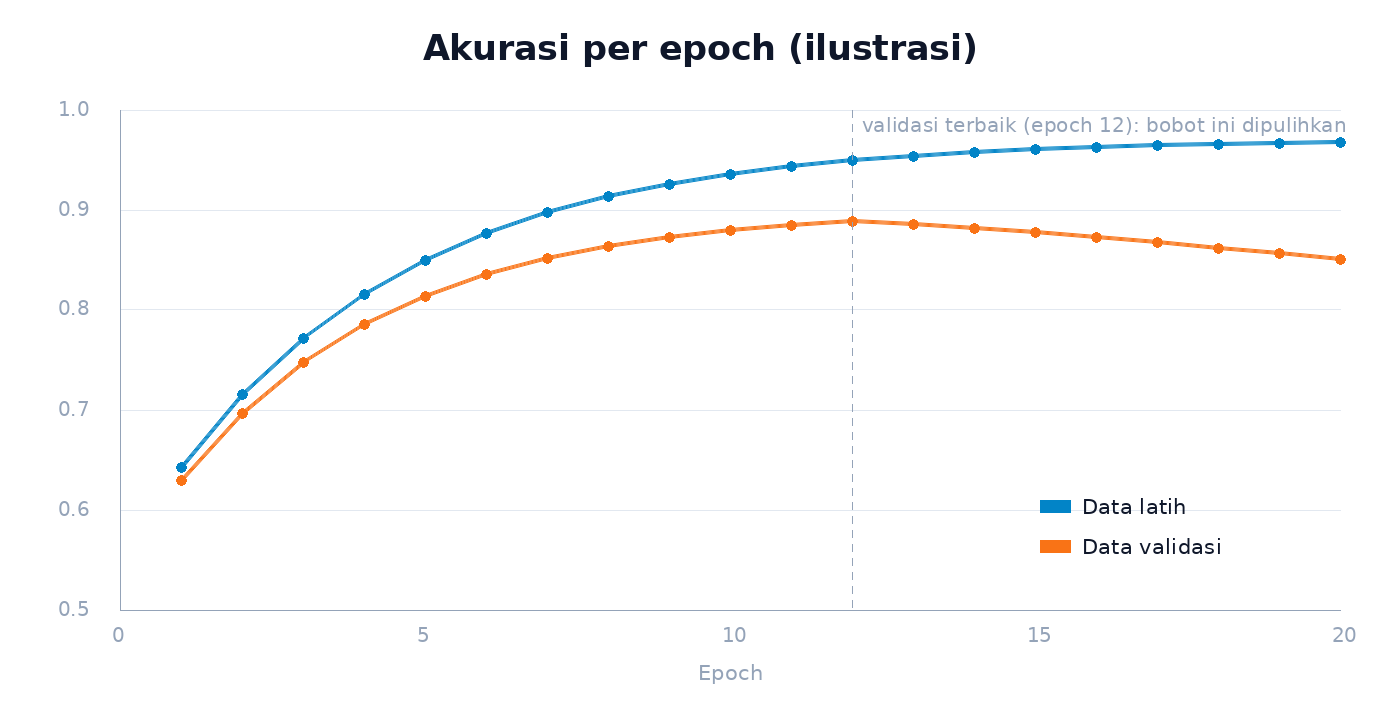
Gambar 2. Ilustrasi kurva akurasi. Setelah epoch 12 akurasi latih terus naik tetapi akurasi validasi turun — tanda overfitting. Dengan patience=5, early stopping menghentikan pelatihan beberapa epoch kemudian dan memulihkan bobot dari epoch terbaik.
Selalu tampilkan grafik seperti ini di Bab IV. Grafik akurasi dan loss untuk data latih dan validasi adalah bukti paling jelas apakah model belajar dengan sehat.
Langkah 4: Transfer learning untuk data terbatas
Transfer learning memakai model yang sudah dilatih pada jutaan gambar (misalnya ImageNet) sebagai pengekstraksi fitur. Anda cukup melatih lapisan klasifikasi di atasnya. Untuk perangkat dengan sumber daya terbatas, MobileNetV2 adalah pilihan yang ringan.
dasar = tf.keras.applications.MobileNetV2(
    input_shape=UKURAN + (3,),
    include_top=False,
    weights="imagenet",
)
dasar.trainable = False  # bekukan bobot hasil pralatih

masukan = tf.keras.Input(shape=UKURAN + (3,))
x = augmentasi(masukan)
x = tf.keras.applications.mobilenet_v2.preprocess_input(x)
x = dasar(x, training=False)
x = layers.GlobalAveragePooling2D()(x)
x = layers.Dropout(0.2)(x)
keluaran = layers.Dense(len(nama_kelas), activation="softmax")(x)

model_tl = tf.keras.Model(masukan, keluaran)
model_tl.compile(
    optimizer=tf.keras.optimizers.Adam(learning_rate=1e-3),
    loss="sparse_categorical_crossentropy",
    metrics=["accuracy"],
)
Perhatikan bahwa MobileNetV2 memakai preprocess_input miliknya sendiri, bukan Rescaling(1.0 / 255). Memakai praproses yang salah adalah penyebab umum akurasi transfer learning yang anehnya rendah.
Setelah lapisan atas terlatih, Anda bisa melakukan fine-tuning: membuka sebagian lapisan teratas model dasar dan melatih ulang dengan learning rate yang jauh lebih kecil (misalnya 1e-5).
Langkah 5: Evaluasi yang layak dilaporkan
Akurasi saja sering menyesatkan, terutama bila jumlah data antarkelas tidak seimbang. Laporkan juga presisi, recall, dan F1-score per kelas.
| Metrik | Rumus | Pertanyaan yang dijawab |
|---|---|---|
| Akurasi | (TP + TN) / total | Berapa persen prediksi yang benar secara keseluruhan? |
| Presisi | TP / (TP + FP) | Dari yang diprediksi "plastik", berapa yang benar plastik? |
| Recall | TP / (TP + FN) | Dari semua plastik sebenarnya, berapa yang berhasil dikenali? |
| F1-score | 2 × (P × R) / (P + R) | Rata-rata harmonik presisi dan recall. |
import numpy as np
from sklearn.metrics import classification_report, confusion_matrix

data_uji = tf.keras.utils.image_dataset_from_directory(
    "dataset/uji", image_size=UKURAN, batch_size=BATCH, shuffle=False
)

y_benar = np.concatenate([y for _, y in data_uji])
y_prediksi = np.argmax(model_tl.predict(data_uji), axis=1)

print(classification_report(y_benar, y_prediksi, target_names=nama_kelas))
print(confusion_matrix(y_benar, y_prediksi))
Parameter shuffle=False pada data uji penting: tanpa itu urutan label dan prediksi bisa tidak sejajar, sehingga metrik yang dihitung salah.
Dari confusion matrix, cari pasangan kelas yang paling sering tertukar — misalnya plastik bening dengan kertas mengilap. Analisis seperti ini membuat pembahasan Bab IV jauh lebih bernilai daripada sekadar menyebut angka akurasi.
Langkah 6: Menyusun hasil di skripsi
Penguji menilai proses, bukan hanya angka akhir. Agar eksperimen Anda mudah dipertanggungjawabkan:
Catat konfigurasi setiap percobaan: arsitektur, ukuran gambar, batch, learning rate, augmentasi, jumlah epoch sebenarnya.
Bandingkan minimal dua model, misalnya CNN dari nol sebagai baseline dan MobileNetV2 sebagai model usulan.
Tetapkan seed dan simpan versi pustaka (
pip freeze > requirements.txt) agar hasil bisa diulang.Simpan model final dengan
model_tl.save("model_sampah.keras")dan sertakan contoh prediksi gambar baru.Jelaskan keterbatasan secara jujur: ukuran dataset, kondisi pencahayaan, atau kelas yang belum tercakup.
Penutup
Membangun model klasifikasi gambar dengan CNN bukan lagi pekerjaan yang menakutkan. Kuncinya ada pada disiplin: data yang bersih dan terbagi dengan benar, baseline yang sederhana, transfer learning ketika data terbatas, serta evaluasi yang jujur dan lengkap. Dengan alur ini, Anda tidak hanya mendapatkan model yang bekerja, tetapi juga skripsi yang mudah dipertahankan di depan penguji.
Jika Anda membutuhkan pendampingan menyusun penelitian atau source code seperti contoh di atas, silakan lihat halaman layanan atau hubungi kami untuk konsultasi.
Bagikan artikel ini
Komentar
Belum ada komentar. Jadilah yang pertama berdiskusi.