Regresi Linear Sederhana untuk Prediksi: Menghitung Koefisien dan Membaca R Kuadrat secara Manual
Panduan lengkap regresi linear sederhana dengan contoh hitung manual 6 data jam belajar dan nilai ujian, rumus koefisien a dan b, tafsiran R kuadrat, serta implementasi Python.
Oleh Ade Taopik Hidayatuloh, S.Kom., M.Kom. 12 menit baca
Daftar isi
- Konsep Dasar Variabel Bebas, Variabel Terikat, dan Garis Regresi
- Langkah Regresi Linear Sederhana Perhitungan Manual dari Enam Sampel Data
- Menghitung dan Menafsirkan Koefisien Determinasi R Kuadrat
- Simulasi Prediksi Nilai Ujian Berdasarkan Jam Belajar dan Batasannya
- Dari Hitungan Manual ke Program
- Kesalahan Umum dalam Menerapkan Regresi Linear pada Penelitian Skripsi
- Referensi
Memahami metode regresi linear sederhana perhitungan manual merupakan fondasi penting bagi mahasiswa dan peneliti yang ingin menguasai analisis statistik prediktif sebelum beralih ke model pembelajaran mesin yang lebih kompleks. Sering kali mahasiswa tingkat akhir langsung memasukkan kumpulan data mentah ke dalam paket perangkat lunak pengolah data dan menyalin angka koefisien ke dalam draf Bab IV tanpa benar-benar memahami bagaimana garis regresi terbentuk. Ketika dosen penguji sidang meminta penjelasan mengenai arti intersep atau bagaimana nilai koefisien determinasi diperoleh, banyak yang terdiam karena hanya mengandalkan keluaran otomatis.
Regresi linear sederhana bekerja dengan memodelkan hubungan fungsional linier antara satu variabel bebas (independen) dan satu variabel terikat (dependen). Tujuan utamanya bukan sekadar menarik garis lurus sembarangan melintasi sebaran titik data, melainkan menemukan satu garis optimal yang meminimalkan jumlah kuadrat selisih antara nilai aktual di lapangan dan nilai prediksi model. Prinsip kuadrat terkecil (*ordinary least squares*) inilah yang menjadi motor penggerak di balik perhitungan parameter statistik yang akurat.
Dalam artikel ini, Anda akan mempelajari penurunan persamaan regresi linear sederhana perhitungan manual langkah demi langkah menggunakan contoh kasus enam mahasiswa di Kelompok Belajar A. Kita akan menghitung koefisien kemiringan arah, intersep titik potong sumbu tegak, koefisien korelasi Pearson, hingga rasio variansi yang dijelaskan oleh nilai R kuadrat. Dengan memahami setiap operasi aljabar di balik rumus tersebut, Anda akan memiliki rasa percaya diri yang tinggi dalam mempertahankan validitas metodologi skripsi Anda.
Konsep Dasar Variabel Bebas, Variabel Terikat, dan Garis Regresi
Langkah pertama dalam perancangan analisis regresi adalah membedakan secara tegas posisi variabel bebas dan variabel terikat berdasarkan kerangka teoritis penelitian. Variabel bebas, yang secara konvensi disimbolkan dengan huruf \(X\), adalah faktor perlakuan atau prediktor yang variasinya diasumsikan memengaruhi variabel lain. Sebaliknya, variabel terikat yang disimbolkan dengan huruf \(Y\) adalah variabel kriteria atau respons yang perilakunya ingin kita prediksi berdasarkan fluktuasi nilai \(X\).
Sebagai ilustrasi contoh kasus, bayangkan Anda sedang meneliti pengaruh waktu persiapan belajar mandiri terhadap capaian hasil ujian statistik di sebuah program studi. Pada skenario ini, jam belajar mingguan bertindak sebagai variabel bebas \(X\), sedangkan skor nilai ujian akhir semester bertindak sebagai variabel terikat \(Y\). Garis matematis yang menghubungkan kedua variabel tersebut dinyatakan dalam bentuk persamaan linier baku:
\[ \hat{Y} = a + bX \]
dengan \(\hat{Y}\) melambangkan nilai duga atau estimasi dari variabel terikat, \(a\) adalah konstanta intersep (titik potong garis pada sumbu tegak saat \(X = 0\)), dan \(b\) adalah koefisien regresi atau kemiringan arah (*slope*). Nilai \(b\) menunjukkan seberapa besar perkiraan perubahan nilai \(Y\) untuk setiap peningkatan satu satuan pada nilai \(X\). Bila tanda koefisien \(b\) positif, hubungan kedua variabel bersifat searah; bila negatif, hubungan bersifat berkebalikan.
Dalam kenyataan empiris, titik-titik data aktual \(Y_i\) jarang sekali berada persis di atas garis lurus sempurna. Selisih antara nilai observasi nyata dan nilai perkiraan garis disebut sebagai residual atau kesalahan acak (error), yang dirumuskan sebagai \(e_i = Y_i - \hat{Y}_i\). Metode kuadrat terkecil mencari kombinasi nilai \(a\) dan \(b\) sedemikian rupa sehingga jumlah seluruh kuadrat residual, yakni \(\sum e_i^2\), mencapai nilai minimum mutlak.
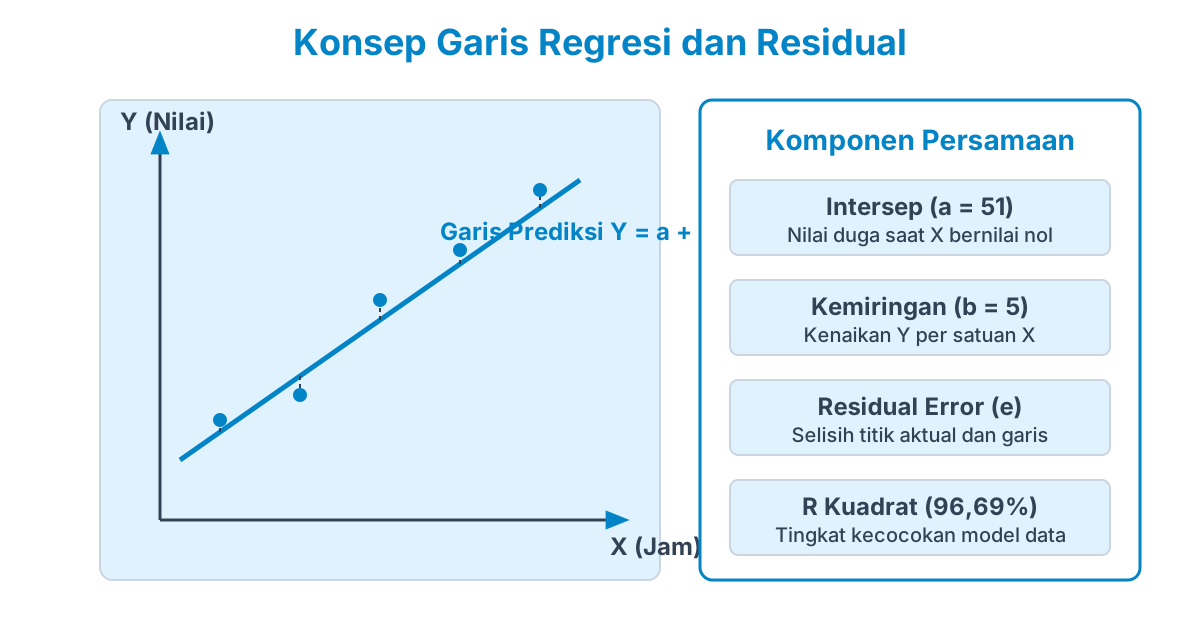
Konsep garis regresi linear estimasi kuadrat terkecil dan selisih residual terhadap titik data aktual. Sumber: diagram oleh Metodika.
Langkah Regresi Linear Sederhana Perhitungan Manual dari Enam Sampel Data
Untuk menghitung nilai parameter regresi tanpa bantuan komputer, kita memerlukan tabel bantu statistik yang merangkum nilai akumulasi penjumlahan. Rumus standar metode kuadrat terkecil untuk menghitung kemiringan \(b\) dan intersep \(a\) dinyatakan sebagai berikut:
\[ b = \frac{n \sum XY - (\sum X)(\sum Y)}{n \sum X^2 - (\sum X)^2} \qquad a = \frac{\sum Y - b \sum X}{n} = \bar{Y} - b\bar{X} \]
dengan \(n\) adalah banyaknya pasangan data observasi, \(\bar{X}\) adalah nilai rata-rata sampel variabel bebas, dan \(\bar{Y}\) adalah nilai rata-rata sampel variabel terikat. Kita gunakan data hipotesis enam mahasiswa Kelompok Belajar A (nama samaran berlabel contoh) dengan data jam belajar mingguan \(X\) dan nilai ujian \(Y\):
| Mahasiswa | Jam Belajar (\(X\)) | Nilai Ujian (\(Y\)) | Perkalian \(XY\) | Kuadrat \(X^2\) | Kuadrat \(Y^2\) |
|---|---|---|---|---|---|
| Contoh 1 | \(2\) | \(62\) | \(124\) | \(4\) | \(3.844\) |
| Contoh 2 | \(4\) | \(68\) | \(272\) | \(16\) | \(4.624\) |
| Contoh 3 | \(5\) | \(78\) | \(390\) | \(25\) | \(6.084\) |
| Contoh 4 | \(6\) | \(82\) | \(492\) | \(36\) | \(6.724\) |
| Contoh 5 | \(7\) | \(84\) | \(588\) | \(49\) | \(7.056\) |
| Contoh 6 | \(8\) | \(92\) | \(736\) | \(64\) | \(8.464\) |
| Total (\(\sum\)) | \(32\) | \(466\) | \(2.602\) | \(194\) | \(36.796\) |
Dari baris total tabel di atas, kita memperoleh nilai ringkasan: \(n = 6\), \(\sum X = 32\), \(\sum Y = 466\), \(\sum XY = 2.602\), \(\sum X^2 = 194\), dan \(\sum Y^2 = 36.796\). Rata-rata masing-masing variabel adalah \(\bar{X} = \frac{32}{6} \approx 5{,}3333\) jam dan \(\bar{Y} = \frac{466}{6} \approx 77{,}6667\) poin.
Sekarang kita masukkan angka-angka tersebut ke dalam rumus koefisien \(b\):
\[ b = \frac{6(2.602) - (32)(466)}{6(194) - (32)^2} = \frac{15.612 - 14.912}{1.164 - 1.024} = \frac{700}{140} = 5{,}0000 \]
Hasil kemiringan adalah persis \(b = 5\). Selanjutnya kita hitung nilai konstanta intersep \(a\):
\[ a = \frac{466 - 5(32)}{6} = \frac{466 - 160}{6} = \frac{306}{6} = 51{,}0000 \]
Dengan demikian, persamaan regresi linear sederhana untuk data sampel ini adalah:
\[ \hat{Y} = 51 + 5X \]
Tafsiran dari model ini sangat jelas: nilai intersep \(a = 51\) menunjukkan bahwa seorang mahasiswa yang belajar nol jam (\(X = 0\)) diestimasikan memperoleh nilai dasar ujian sebesar 51. Sementara itu, nilai kemiringan \(b = 5\) mengindikasikan bahwa setiap penambahan 1 jam waktu belajar akan mendongkrak estimasi nilai ujian sebesar 5 poin secara linier.
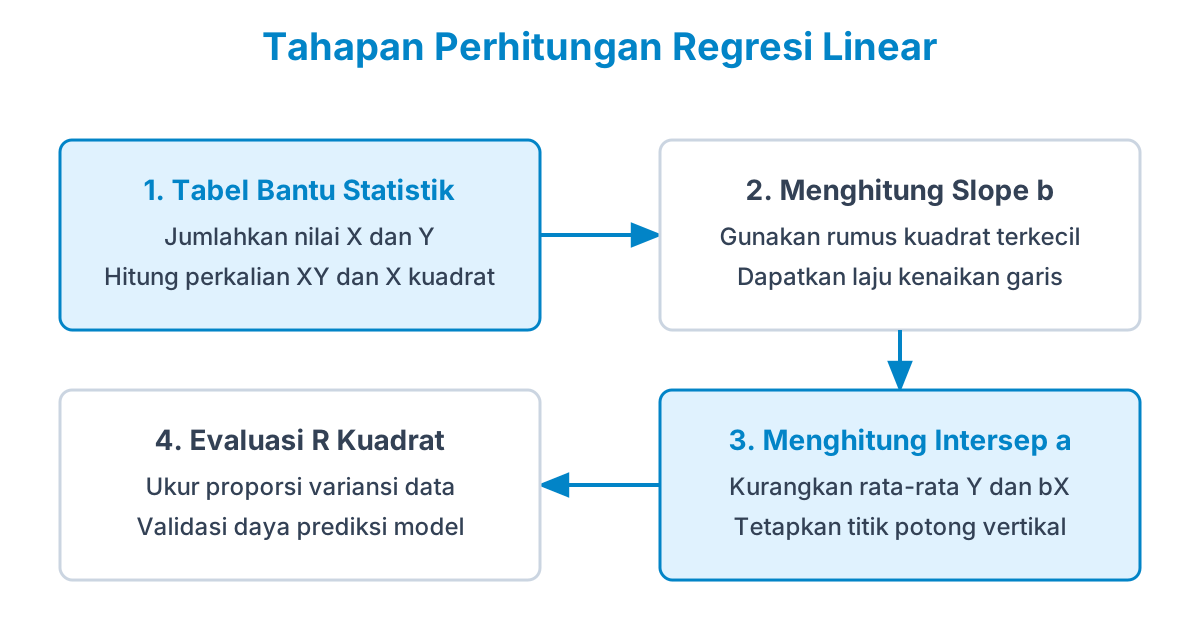
Empat tahapan utama perhitungan regresi linear dari penyusunan tabel bantu hingga evaluasi nilai R kuadrat. Sumber: diagram oleh Metodika.
Menghitung dan Menafsirkan Koefisien Determinasi R Kuadrat
Setelah mendapatkan garis persamaan, pertanyaan kritis berikutnya adalah seberapa baik garis tersebut mewakili data observasi. Untuk menjawab hal ini, kita menghitung koefisien korelasi Pearson \(r\) dan koefisien determinasi \(R^2\). Korelasi Pearson mengukur kekuatan hubungan linier, sebagaimana yang juga dipaparkan dalam bahasan kami mengenai uji validitas dan reliabilitas instrumen dengan korelasi Pearson.
Rumus korelasi Pearson \(r\) menggunakan angka ringkasan tabel bantu adalah:
\[ r = \frac{n \sum XY - (\sum X)(\sum Y)}{\sqrt{\left[n \sum X^2 - (\sum X)^2\right] \left[n \sum Y^2 - (\sum Y)^2\right]}} \]
Kita hitung bagian penyebut kedua terlebih dahulu:
\[ n \sum Y^2 - (\sum Y)^2 = 6(36.796) - (466)^2 = 220.776 - 217.156 = 3.620 \]
Maka koefisien korelasi \(r\) menjadi:
\[ r = \frac{700}{\sqrt{140 \times 3.620}} = \frac{700}{\sqrt{506.800}} = \frac{700}{711{,}8989} \approx 0{,}9833 \]
Nilai \(r \approx 0{,}9833\) menunjukkan adanya korelasi positif yang sangat kuat antara jam belajar dan nilai ujian. Sekarang kita dapat menghitung koefisien determinasi \(R^2\) dengan mengkuadratkan nilai \(r\):
\[ R^2 = (0{,}9833)^2 \approx 0{,}9669 \]
Kita juga dapat memverifikasi nilai \(R^2\) melalui dekomposisi jumlah kuadrat selisih (*sum of squares*):
\[ SS_{\text{tot}} = \sum Y^2 - \frac{(\sum Y)^2}{n} = 36.796 - \frac{217.156}{6} = 36.796 - 36.192{,}67 = 603{,}3333 \]
Kita susun tabel verifikasi residual untuk menghitung jumlah kuadrat sisa (\(SS_{\text{res}}\)):
| Mahasiswa | Jam (\(X\)) | Aktual (\(Y\)) | Prediksi (\(\hat{Y} = 51 + 5X\)) | Residual (\(e = Y - \hat{Y}\)) | Kuadrat Residual (\(e^2\)) |
|---|---|---|---|---|---|
| Contoh 1 | \(2\) | \(62\) | \(51 + 5(2) = 61\) | \(62 - 61 = 1\) | \(1\) |
| Contoh 2 | \(4\) | \(68\) | \(51 + 5(4) = 71\) | \(68 - 71 = -3\) | \(9\) |
| Contoh 3 | \(5\) | \(78\) | \(51 + 5(5) = 76\) | \(78 - 76 = 2\) | \(4\) |
| Contoh 4 | \(6\) | \(82\) | \(51 + 5(6) = 81\) | \(82 - 81 = 1\) | \(1\) |
| Contoh 5 | \(7\) | \(84\) | \(51 + 5(7) = 86\) | \(84 - 86 = -2\) | \(4\) |
| Contoh 6 | \(8\) | \(92\) | \(51 + 5(8) = 91\) | \(92 - 91 = 1\) | \(1\) |
| Total | \(32\) | \(466\) | \(466\) | \(0\) | \(SS_{\text{res}} = 20\) |
Perhatikan bahwa jumlah residual selalu bernilai nol (\(\sum e = 0\)), yang membuktikan bahwa garis regresi tepat membelah pusat massa data. Dengan \(SS_{\text{res}} = 20\), kita peroleh jumlah kuadrat regresi \(SS_{\text{reg}} = SS_{\text{tot}} - SS_{\text{res}} = 603{,}3333 - 20 = 583{,}3333\). Maka koefisien determinasi adalah:
\[ R^2 = \frac{SS_{\text{reg}}}{SS_{\text{tot}}} = \frac{583{,}3333}{603{,}3333} \approx 0{,}9669 \]
Tafsiran ilmiahnya: sebesar 96,69 persen variasi skor nilai ujian dapat dijelaskan secara langsung oleh variasi jam belajar melalui model regresi linier ini. Adapun sisanya, yakni sekitar 3,31 persen, dipengaruhi oleh faktor lain di luar model, seperti motivasi belajar, kualitas tidur malam sebelum ujian, atau penguasaan materi dasar sebelumnya.
Suasana meja kerja komputasi dan analisis data numerik. Sumber: commons.wikimedia.org, lisensi CC0.
Simulasi Prediksi Nilai Ujian Berdasarkan Jam Belajar dan Batasannya
Setelah persamaan regresi dinyatakan valid dan memiliki nilai determinasi yang tinggi, model ini dapat dimanfaatkan untuk melakukan estimasi prediksi bagi mahasiswa baru. Katakanlah seorang mahasiswa bernama Contoh 7 meluangkan waktu belajar selama 6,5 jam. Berapa perkiraan nilai ujian yang akan diperoleh?
Kita substitusikan nilai \(X = 6{,}5\) ke dalam rumus persamaan yang telah kita temukan:
\[ \hat{Y} = 51 + 5(6{,}5) = 51 + 32{,}5 = 83{,}50 \]
Model memprediksi mahasiswa tersebut akan memperoleh nilai ujian sebesar 83,50 poin. Estimasi semacam ini disebut sebagai interpolasi karena nilai \(X = 6{,}5\) berada di dalam rentang sampel pengamatan data kita (yakni antara 2 hingga 8 jam belajar).
Meskipun demikian, ada batasan metodologis penting yang wajib Anda perhatikan: bahaya ekstrapolasi. Ekstrapolasi terjadi manakala Anda memaksakan model regresi untuk memprediksi nilai \(X\) yang jauh berada di luar jangkauan data observasi sampel. Sebagai contoh, jika seorang mahasiswa belajar 15 jam, persamaan matematis akan menghasilkan estimasi \(\hat{Y} = 51 + 5(15) = 126\). Nilai 126 jelas tidak masuk akal karena skala nilai ujian maksimal umumnya hanya 100.
Di dunia nyata, hubungan biologis dan kognitif manusia tidak selalu linier tanpa batas. Pada titik tertentu berlaku hukum imbal hasil yang menurun (*law of diminishing returns*), di mana kelelahan mental justru dapat menurunkan performa kognitif meskipun jam belajar ditambah. Oleh karena itu, batasi penggunaan persamaan regresi linier hanya pada rentang rentang observasi empiris yang teruji.
Dari Hitungan Manual ke Program
Untuk memvalidasi ketepatan hitungan manual yang telah kita selesaikan, Anda dapat menulis skrip sederhana menggunakan bahasa pemrograman Python. Penggunaan kode program memungkinkan otomatisasi perhitungan pada himpunan data yang terdiri dari ribuan baris. Anda juga dapat memadukannya dengan algoritma klasifikasi berbasis kedekatan data seperti yang diulas pada artikel K-Nearest Neighbor untuk klasifikasi data.
Berikut adalah potongan kode Python inti untuk menghitung koefisien regresi \(a\), \(b\), dan \(R^2\):
x, y = [2, 4, 5, 6, 7, 8], [62, 68, 78, 82, 84, 92]
n = len(x)
b = (n * sum(a*b for a,b in zip(x,y)) - sum(x)*sum(y)) / (n * sum(a**2 for a in x) - sum(x)**2)
a = (sum(y) - b * sum(x)) / n
ss_res = sum((act - (a + b*val))**2 for val, act in zip(x, y))
r2 = 1 - (ss_res / sum((val - sum(y)/n)**2 for val in y))
print(f"Y = {a:.0f} + {b:.0f}X | R2 = {r2:.4f}")
Saat Anda menjalankan skrip di atas, keluaran program akan menampilkan nilai persis yang sama dengan hitungan manual kita: konstanta \(a = 51{,}00\), kemiringan \(b = 5{,}00\), \(SS_{\text{res}} = 20{,}00\), dan \(R^2 = 0{,}9669\). Kesesuaian antara rumus analitis dan eksekusi program ini memberi kepastian bahwa logika komputasi yang Anda gunakan di Bab IV telah teruji secara menyeluruh.
Kesalahan Umum dalam Menerapkan Regresi Linear pada Penelitian Skripsi
Dalam proses penulisan laporan penelitian kuantitatif, terdapat beberapa kekeliruan metodologis klasik yang sering menjadi sasaran kritik dewan penguji skripsi:
- Menyamakan Korelasi dengan Kausalitas: Nilai korelasi \(r = 0{,}9833\) yang tinggi membuktikan adanya kovariasi statistik, tetapi tidak serta-merta membuktikan bahwa penambahan jam belajar adalah satu-satunya penyebab kenaikan nilai. Hubungan sebab-akibat harus diperkuat oleh landasan teori pedagogi yang kuat dan kontrol terhadap variabel pengganggu.
- Mengabaikan Uji Asumsi Klasik: Sebelum menarik kesimpulan akhir, model regresi OLS wajib lolos serangkaian uji diagnostik, termasuk uji normalitas residual, uji heterokedastisitas, dan uji linieritas hubungan. Mengabaikan uji asumsi ini dapat membuat estimasi interval kepercayaan menjadi bias.
- Terjebak Nilai R Kuadrat Palsu: Nilai determinasi yang mendekati 100 persen memang menyenangkan, namun pada sampel data kecil hal itu rentan mencerminkan kecocokan berlebih (*overfitting*). Pastikan Anda selalu melaporkan jumlah sampel observasi dan mempertimbangkan metrik penyesuaian (*Adjusted R-Squared*) saat menambah variabel prediktor baru.
- Membiarkan Data Pencilan (Outliers): Kehadiran satu data ekstrem (misalnya mahasiswa yang belajar 10 jam tetapi mendapat nilai 30 karena sakit) dapat memutar arah kemiringan garis regresi secara drastis. Lakukan pemeriksaan diagram tebar (*scatter plot*) terlebih dahulu untuk mendeteksi data pencilan sebelum memulai perhitungan.
Dengan menguasai alur regresi linear sederhana perhitungan manual ini, Anda tidak hanya mampu menyajikan analisis data yang kredibel di naskah skripsi, tetapi juga memahami esensi kerja algoritma pembelajaran mesin linier yang digunakan secara luas di industri teknologi saat ini.
Referensi
Montgomery, D. C., Peck, E. A., & Vining, G. G. (2021). Introduction to Linear Regression Analysis (6th ed.). John Wiley & Sons.
Walpole, R. E., Myers, R. H., Myers, S. L., & Ye, K. (2016). Probability & Statistics for Engineers & Scientists (9th ed.). Pearson Education.
Gambar sampul: Shixart1985, commons.wikimedia.org, lisensi CC BY.
Bagikan artikel ini
Komentar
Belum ada komentar. Jadilah yang pertama berdiskusi.