Metode TOPSIS: Menentukan Solusi Ideal Positif dan Negatif dengan Contoh Hitung Manual
Panduan lengkap metode TOPSIS untuk sistem pendukung keputusan dengan contoh hitung manual pemilihan lokasi usaha, normalisasi matriks, dan skrip Python.
Oleh Ade Taopik Hidayatuloh, S.Kom., M.Kom. 12 menit baca
Daftar isi
Dalam pengambilan keputusan multikriteria, mahasiswa sistem informasi dan informatika sering kali dihadapkan pada pilihan algoritma yang paling tepat untuk memecahkan dilema pemilihan alternatif terbaik. Salah satu pendekatan yang paling populer dan memiliki fondasi geometris yang kokoh adalah metode TOPSIS (Technique for Order of Preference by Similarity to Ideal Solution). Keunggulan utama metode ini terletak pada konsepnya yang intuitif: alternatif terbaik bukan hanya yang memiliki kinerja tertinggi pada kriteria yang menguntungkan, melainkan yang secara geometris paling dekat dengan solusi ideal positif sekaligus paling jauh dari solusi ideal negatif.
Banyak laporan skripsi yang mengalami revisi berat pada Bab IV karena mahasiswa hanya menyajikan hasil akhir perangkingan dari perangkat lunak tanpa mampu membuktikan kebenaran perhitungannya secara manual di hadapan dosen penguji. Menghitung setiap tahapan matriks secara bertahap memberikan pemahaman mendalam tentang bagaimana bobot preferensi berinteraksi dengan normalisasi vektor data observasi.
Konsep Dasar Metode TOPSIS dan Perbandingannya dengan SAW serta AHP
Metode TOPSIS pertama kali diperkenalkan oleh Ching-Lai Hwang dan Kwangsun Yoon pada tahun 1981 sebagai solusi penentuan peringkat multikriteria berbasis jarak relatif. Untuk memahami posisi TOPSIS dalam rumpun sistem pendukung keputusan, kita perlu membandingkannya dengan metode klasik lain yang sering digunakan dalam penelitian akademik:
- Perbandingan dengan SAW: Sebagaimana telah kita pelajari pada ulasan metode Simple Additive Weighting (SAW), algoritma SAW melakukan normalisasi skala linier dengan membagi nilai kriteria terhadap nilai maksimum atau minimum. Sebaliknya, TOPSIS menggunakan normalisasi vektor berbasis norma Euclidean, sehingga proporsi variasi data antarelemen tetap terjaga dalam ruang berdimensi banyak.
- Perbandingan dengan AHP: Pada metode Analytical Hierarchy Process (AHP) untuk pembobotan kriteria, fokus utama diletakkan pada perbandingan berpasangan antarvariabel guna menghasilkan bobot prioritas yang konsisten. Dalam berbagai rancangan sistem pendukung keputusan modern, AHP sering dikombinasikan dengan TOPSIS, di mana AHP bertugas menentukan bobot kriteria sementara TOPSIS mengeksekusi perangkingan akhir alternatif.
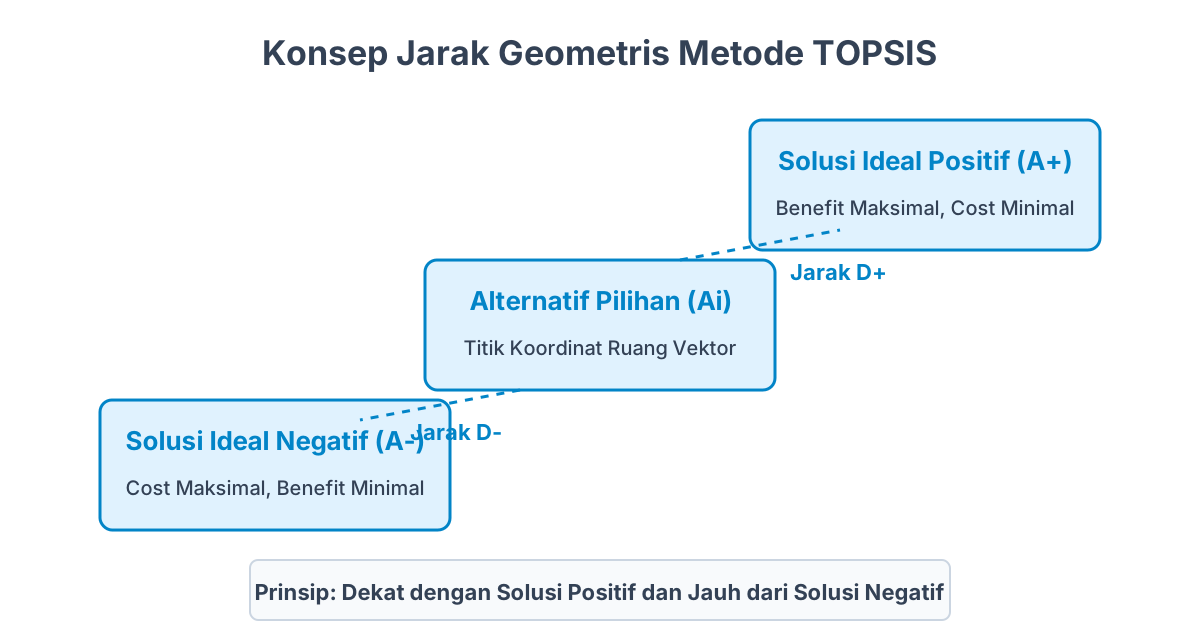
Prinsip geometris metode TOPSIS dalam ruang vektor kriteria keputusan. Sumber: diagram oleh Metodika.
Prinsip kerja geometris TOPSIS dapat dibayangkan sebagai penentuan jarak dalam ruang koordinat. Solusi Ideal Positif merepresentasikan titik hipotesis sempurna yang memadukan performa terbaik dari semua kriteria keuntungan (*benefit*) dan performa terendah dari semua kriteria biaya (*cost*). Sebaliknya, Solusi Ideal Negatif menghimpun titik terburuk yang harus dihindari oleh pengambil keputusan.
Tahapan Matematis Normalisasi Vektor dan Pembobotan Matriks
Prosedur komputasi TOPSIS dibangun melalui enam langkah formal yang sistematis. Dimulai dari pembentukan matriks keputusan awal \(X\) berukuran \(m \times n\), di mana \(m\) adalah jumlah alternatif dan \(n\) adalah jumlah kriteria penilaian:
\[ X = \begin{bmatrix} x_{11} & x_{12} & \dots & x_{1n} \\ x_{21} & x_{22} & \dots & x_{2n} \\ \vdots & \vdots & \ddots & \vdots \\ x_{m1} & x_{m2} & \dots & x_{mn} \end{bmatrix} \]
Langkah pertama adalah menghitung matriks ternormalisasi \(R = [r_{ij}]\) menggunakan rumus normalisasi pembagi norma Euclidean:
\[ r_{ij} = \frac{x_{ij}}{\sqrt{\sum_{k=1}^m x_{kj}^2}} \]
Setelah elemen ternormalisasi diperoleh, setiap kolom kriteria dikalikan dengan bobot preferensi masing-masing \(w_j\) untuk membentuk matriks ternormalisasi terbobot \(Y = [y_{ij}]\):
\[ y_{ij} = w_j \cdot r_{ij} \]
dengan syarat total akumulasi seluruh bobot kriteria adalah satu: \(\sum_{j=1}^n w_j = 1\).
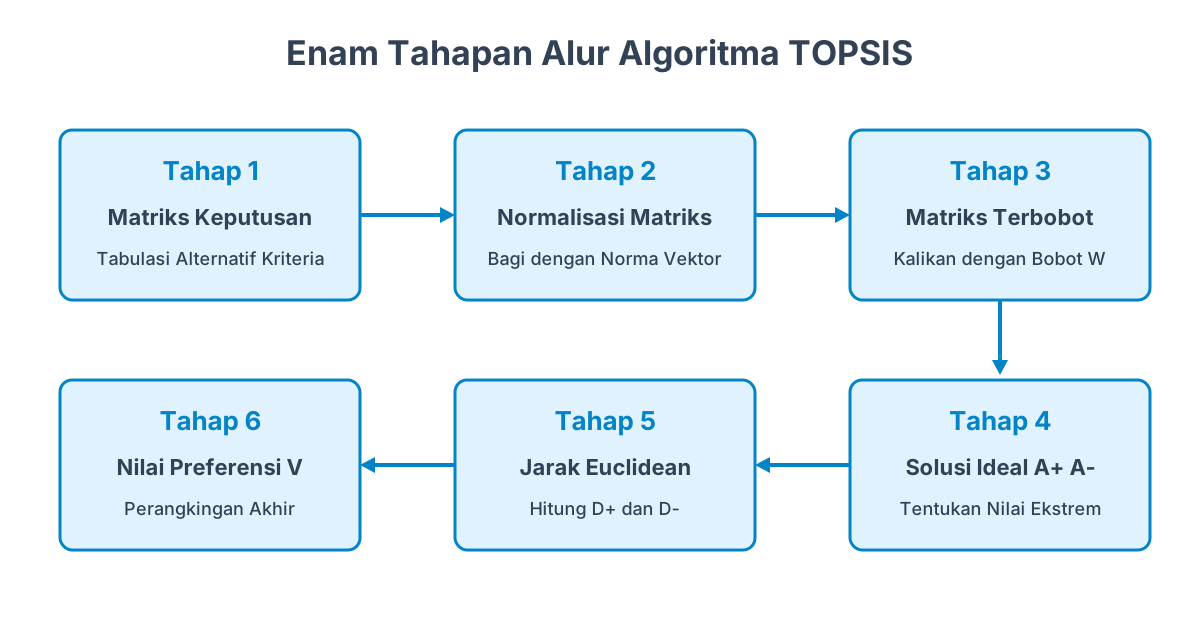
Enam tahapan sistematis perhitungan algoritma TOPSIS dalam pengambilan keputusan. Sumber: diagram oleh Metodika.
Tahap selanjutnya adalah menentukan himpunan Solusi Ideal Positif (\(A^+\)) dan Solusi Ideal Negatif (\(A^-\)):
\[ A^+ = \{y_1^+, y_2^+, \dots, y_n^+\} \qquad A^- = \{y_1^-, y_2^-, \dots, y_n^-\} \]
Aturan penentuannya sangat tegas: untuk kriteria bertipe keuntungan (*benefit*), nilai \(y_j^+\) adalah nilai maksimum pada kolom tersebut dan \(y_j^-\) adalah nilai minimum. Sebaliknya, untuk kriteria bertipe biaya (*cost*), nilai \(y_j^+\) adalah nilai minimum dan \(y_j^-\) adalah nilai maksimum.
Contoh Kasus Hitung Manual Pemilihan Lokasi Usaha Toko Z
Untuk memberikan gambaran yang utuh, kita gunakan simulasi studi kasus pemilihan lokasi cabang baru bagi usaha ritel Toko Z (nama samaran berlabel contoh). Terdapat tiga alternatif lokasi yang sedang dipertimbangkan: Ruko Sentra Niaga (\(A_1\)), Ruko Komersial Barat (\(A_2\)), dan Ruko Kawasan Timur (\(A_3\)). Evaluasi dilakukan berdasarkan empat kriteria terukur:
- \(C_1\) Biaya Sewa Tahunan (Juta Rupiah): Kriteria Biaya (*Cost*), bobot \(w_1 = 0{,}30\). Semakin murah biaya sewa, semakin menguntungkan bagi anggaran toko.
- \(C_2\) Kepadatan Pengunjung (Skala 1-100): Kriteria Keuntungan (*Benefit*), bobot \(w_2 = 0{,}25\). Mengukur estimasi keramaian calon konsumen potensial.
- \(C_3\) Aksesibilitas dan Lahan Parkir (Skala 1-100): Kriteria Keuntungan (*Benefit*), bobot \(w_3 = 0{,}25\). Kemudahan akses transportasi dan ketersediaan ruang parkir.
- \(C_4\) Jumlah Pesaing Sejenis dalam Radius 500 Meter (Unit): Kriteria Biaya (*Cost*), bobot \(w_4 = 0{,}20\). Tingkat kejenuhan kompetisi pasar di sekitar lokasi.
Berikut adalah matriks keputusan awal \(X\) yang merangkum data observasi ketiga lokasi ruko:
| Alternatif Lokasi | Biaya Sewa \(C_1\) (Cost) | Potensi Pasar \(C_2\) (Benefit) | Aksesibilitas \(C_3\) (Benefit) | Kompetitor \(C_4\) (Cost) |
|---|---|---|---|---|
| Ruko Sentra Niaga (\(A_1\)) | \(36\) | \(80\) | \(70\) | \(3\) |
| Ruko Komersial Barat (\(A_2\)) | \(48\) | \(75\) | \(85\) | \(5\) |
| Ruko Kawasan Timur (\(A_3\)) | \(60\) | \(90\) | \(60\) | \(2\) |
Kita hitung nilai pembagi norma Euclidean untuk masing-masing kolom kriteria:
\[ \text{Pembagi } C_1 = \sqrt{36^2 + 48^2 + 60^2} = \sqrt{1.296 + 2.304 + 3.600} = \sqrt{7.200} \approx 84{,}8528 \]
\[ \text{Pembagi } C_2 = \sqrt{80^2 + 75^2 + 90^2} = \sqrt{6.400 + 5.625 + 8.100} = \sqrt{20.125} \approx 141{,}8626 \]
\[ \text{Pembagi } C_3 = \sqrt{70^2 + 85^2 + 60^2} = \sqrt{4.900 + 7.225 + 3.600} = \sqrt{15.725} \approx 125{,}3994 \]
\[ \text{Pembagi } C_4 = \sqrt{3^2 + 5^2 + 2^2} = \sqrt{9 + 25 + 4} = \sqrt{38} \approx 6{,}1644 \]
Dengan membagi setiap sel data mentah terhadap nilai pembagi kolomnya, kita memperoleh matriks ternormalisasi \(R\):
| Alternatif | \(r_{i1}\) | \(r_{i2}\) | \(r_{i3}\) | \(r_{i4}\) |
|---|---|---|---|---|
| \(A_1\) | \(36 / 84{,}8528 = 0{,}4243\) | \(80 / 141{,}8626 = 0{,}5639\) | \(70 / 125{,}3994 = 0{,}5582\) | \(3 / 6{,}1644 = 0{,}4867\) |
| \(A_2\) | \(48 / 84{,}8528 = 0{,}5657\) | \(75 / 141{,}8626 = 0{,}5287\) | \(85 / 125{,}3994 = 0{,}6778\) | \(5 / 6{,}1644 = 0{,}8111\) |
| \(A_3\) | \(60 / 84{,}8528 = 0{,}7071\) | \(90 / 141{,}8626 = 0{,}6344\) | \(60 / 125{,}3994 = 0{,}4785\) | \(2 / 6{,}1644 = 0{,}3244\) |
Selanjutnya, kalikan elemen matriks \(R\) dengan bobot \(W = [0{,}30; 0{,}25; 0{,}25; 0{,}20]\) untuk menghasilkan matriks ternormalisasi terbobot \(Y\):
| Alternatif | \(y_{i1} (w_1=0{,}30)\) | \(y_{i2} (w_2=0{,}25)\) | \(y_{i3} (w_3=0{,}25)\) | \(y_{i4} (w_4=0{,}20)\) |
|---|---|---|---|---|
| \(A_1\) | \(0{,}4243 \times 0{,}30 = 0{,}1273\) | \(0{,}5639 \times 0{,}25 = 0{,}1410\) | \(0{,}5582 \times 0{,}25 = 0{,}1396\) | \(0{,}4867 \times 0{,}20 = 0{,}0973\) |
| \(A_2\) | \(0{,}5657 \times 0{,}30 = 0{,}1697\) | \(0{,}5287 \times 0{,}25 = 0{,}1322\) | \(0{,}6778 \times 0{,}25 = 0{,}1695\) | \(0{,}8111 \times 0{,}20 = 0{,}1622\) |
| \(A_3\) | \(0{,}7071 \times 0{,}30 = 0{,}2121\) | \(0{,}6344 \times 0{,}25 = 0{,}1586\) | \(0{,}4785 \times 0{,}25 = 0{,}1196\) | \(0{,}3244 \times 0{,}20 = 0{,}0649\) |
Sekarang kita dapat mengekstrak Solusi Ideal Positif (\(A^+\)) dan Solusi Ideal Negatif (\(A^-\)) berdasarkan sifat atribut masing-masing kriteria:
- Kolom \(C_1\) (Cost): Nilai terbaik adalah nilai terkecil \(y_1^+ = 0{,}1273\), dan terburuk adalah nilai terbesar \(y_1^- = 0{,}2121\).
- Kolom \(C_2\) (Benefit): Nilai terbaik adalah nilai terbesar \(y_2^+ = 0{,}1586\), dan terburuk adalah nilai terkecil \(y_2^- = 0{,}1322\).
- Kolom \(C_3\) (Benefit): Nilai terbaik adalah nilai terbesar \(y_3^+ = 0{,}1695\), dan terburuk adalah nilai terkecil \(y_3^- = 0{,}1196\).
- Kolom \(C_4\) (Cost): Nilai terbaik adalah nilai terkecil \(y_4^+ = 0{,}0649\), dan terburuk adalah nilai terbesar \(y_4^- = 0{,}1622\).
Sehingga kita memperoleh vektor koordinat acuan ideal:
\[ A^+ = [0{,}1273; 0{,}1586; 0{,}1695; 0{,}0649] \qquad A^- = [0{,}2121; 0{,}1322; 0{,}1196; 0{,}1622] \]
Suasana meja kerja perancangan sistem pendukung keputusan. Sumber: commons.wikimedia.org, lisensi CC0.
Langkah berikutnya adalah menghitung jarak Euclidean setiap alternatif terhadap solusi ideal positif (\(D_i^+\)) dan solusi ideal negatif (\(D_i^-\)):
\[ D_i^+ = \sqrt{\sum_{j=1}^n (y_{ij} - y_j^+)^2} \qquad D_i^- = \sqrt{\sum_{j=1}^n (y_{ij} - y_j^-)^2} \]
Perhitungan jarak untuk alternatif \(A_1\):
\[ D_1^+ = \sqrt{(0{,}1273 - 0{,}1273)^2 + (0{,}1410 - 0{,}1586)^2 + (0{,}1396 - 0{,}1695)^2 + (0{,}0973 - 0{,}0649)^2} \approx 0{,}0475 \]
\[ D_1^- = \sqrt{(0{,}1273 - 0{,}2121)^2 + (0{,}1410 - 0{,}1322)^2 + (0{,}1396 - 0{,}1196)^2 + (0{,}0973 - 0{,}1622)^2} \approx 0{,}1090 \]
Dengan cara hitung yang sama untuk \(A_2\) dan \(A_3\), kita rangkum seluruh jarak dan hitung nilai preferensi relatif \(V_i\):
\[ V_i = \frac{D_i^-}{D_i^+ + D_i^-} \]
| Alternatif Lokasi | Jarak Ideal Positif (\(D_i^+\)) | Jarak Ideal Negatif (\(D_i^-\)) | Nilai Preferensi (\(V_i\)) | Peringkat Akhir |
|---|---|---|---|---|
| Ruko Sentra Niaga (\(A_1\)) | \(0{,}0475\) | \(0{,}1090\) | \(0{,}1090 / (0{,}0475 + 0{,}1090) = 0{,}6965\) | Peringkat 1 (Terpilih) |
| Ruko Kawasan Timur (\(A_3\)) | \(0{,}0984\) | \(0{,}1009\) | \(0{,}1009 / (0{,}0984 + 0{,}1009) = 0{,}5061\) | Peringkat 2 |
| Ruko Komersial Barat (\(A_2\)) | \(0{,}1094\) | \(0{,}0655\) | \(0{,}0655 / (0{,}1094 + 0{,}0655) = 0{,}3743\) | Peringkat 3 |
Hasil akhir menunjukkan bahwa Ruko Sentra Niaga (\(A_1\)) memperoleh nilai preferensi tertinggi sebesar \(V_1 = 0{,}6965\). Hal ini membuktikan bahwa meskipun biaya sewa \(A_1\) bukan yang paling murah absolut dibanding nilai hipotesis nol, kombinasi posisi kriteria \(A_1\) menempatkannya pada posisi yang paling efisien: sangat dekat dengan kondisi ideal dan jauh dari kondisi terburuk.
Dari Hitungan Manual ke Program
Setelah membuktikan seluruh langkah hitungan matematis pada naskah skripsi, Anda dapat menerjemahkan algoritma ini ke dalam program komputer. Implementasi logika matematika ini sangat ringkas dan dapat dieksekusi dengan Python standar:
import math
x, w = [[36, 80, 70, 3], [48, 75, 85, 5], [60, 90, 60, 2]], [0.3, 0.25, 0.25, 0.2]
div = [math.sqrt(sum(x[i][j]**2 for i in range(3))) for j in range(4)]
y = [[(x[i][j]/div[j]) * w[j] for j in range(4)] for i in range(3)]
ap = [min(y[i][0] for i in range(3)), max(y[i][1] for i in range(3)), max(y[i][2] for i in range(3)), min(y[i][3] for i in range(3))]
an = [max(y[i][0] for i in range(3)), min(y[i][1] for i in range(3)), min(y[i][2] for i in range(3)), max(y[i][3] for i in range(3))]
d = [[math.sqrt(sum((y[i][j]-a[j])**2 for j in range(4))) for i in range(3)] for a in (ap, an)]
print('V =', [round(d[1][i] / (d[0][i] + d[1][i]), 4) for i in range(3)])
Keluaran dari program di atas menghasilkan deretan nilai preferensi V = [0.6965, 0.3743, 0.5061] yang identik persis dengan hitungan manual kita di tabel sebelumnya. Konsistensi hasil ini menjamin bahwa sistem perangkat lunak yang Anda bangun di tugas akhir telah memiliki landasan komputasi yang terverifikasi.
Kesalahan Umum dalam Menerapkan Algoritma TOPSIS pada Skripsi
Dalam proses bimbingan dan sidang skripsi, terdapat beberapa kekeliruan fatal yang sering kali membuat mahasiswa harus mengulang perhitungannya:
- Tertukar Menentukan Nilai Ekstrem Kriteria Biaya: Kesalahan paling sering terjadi adalah memperlakukan semua kriteria sebagai kriteria keuntungan. Ingat bahwa pada kriteria biaya (*cost*), nilai ideal positif \(A^+\) justru mengambil nilai terkecil (*minimum*), bukan terbesar. Jika Anda salah menentukan arah ekstrem ini, seluruh nilai jarak dan perangkingan akhir akan berbalik total.
- Menggunakan Normalisasi Linear Milik SAW: Sebagian mahasiswa keliru membagi sel data dengan nilai maksimum kolom (seperti rumus normalisasi SAW). TOPSIS mewajibkan pembagian dengan akar jumlah kuadrat (norma Euclidean). Normalisasi linier akan merusak sifat ruang metrik Euclidean yang menjadi fondasi utama TOPSIS.
- Penentuan Bobot Secara Sembrono: Memberikan bobot kriteria secara acak tanpa landasan teori atau justifikasi pakar akan membuat hasil perangkingan kehilangan legitimasi ilmiah. Sangat disarankan untuk memadukan TOPSIS dengan metode pembobotan terstruktur seperti AHP atau ROC (*Rank Order Centroid*).
- Hanya Menyajikan Angka Tanpa Analisis Sensitivitas: Pada Bab IV, dosen penguji ingin melihat seberapa kokoh peringkat alternatif jika bobot kriteria diubah. Lakukan uji sensitivitas sederhana dengan menaikkan atau menurunkan bobot kriteria utama sebesar sepuluh persen untuk mengamati kestabilan peringkat alternatif pertama.
Dengan menguasai metode TOPSIS secara menyeluruh dari konsep teoritis, penurunan rumus manual, hingga implementasi kodenya, Anda dapat menyajikan Bab IV skripsi yang kuat, meyakinkan, dan siap dipertanggungjawabkan di hadapan dewan penguji.
Referensi
Hwang, C. L., & Yoon, K. (1981). Multiple attribute decision making: Methods and applications a state-of-the-art survey. Springer-Verlag. https://doi.org/10.1007/978-3-642-48318-9
Jahanshir, N., & Rouhani, S. (2020). Extended TOPSIS method for multi-criteria decision making with interval-valued intuitionistic fuzzy sets. Journal of Ambient Intelligence and Humanized Computing, 11(6), 2415-2429.
Kusumadewi, S., Hartati, S., Harjoko, A., & Wardoyo, R. (2006). Fuzzy Multi-Attribute Decision Making (Fuzzy MADM). Graha Ilmu.
Yoon, K. P., & Hwang, C. L. (1995). Multiple attribute decision making: An introduction. SAGE Publications. https://doi.org/10.4135/9781412985161
Gambar sampul: Enoch Leung, commons.wikimedia.org, lisensi CC BY-SA.
Bagikan artikel ini
Komentar
Belum ada komentar. Jadilah yang pertama berdiskusi.