SWE-Bench ProMax Hadirkan Tolok Ukur Baru Pengujian Refaktorisasi Agen Pengode AI
Tolok ukur baru SWE-Bench ProMax menguji agen pengode AI pada refaktorisasi 7 bahasa pemrograman berskala besar, di mana model terdepan hanya raih 41,2 persen.
Sumber: arXiv cs.CL 5 menit baca
Konsorsium peneliti rekayasa perangkat lunak merilis SWE-Bench ProMax, tolok ukur pengujian terkurasi baru untuk mengevaluasi kemampuan agen kecerdasan buatan dalam merestrukturisasi kode program berskala besar di tujuh bahasa pemrograman pada akhir Oktober 2026 di repositori ilmiah terbuka arXiv.
Kehadiran tolok ukur anyar ini dipicu oleh kritik tajam terhadap tolok ukur standar SWE-bench Verified yang dinilai mulai jenuh dan memuat banyak kekeliruan skrip pengujian otomatis.
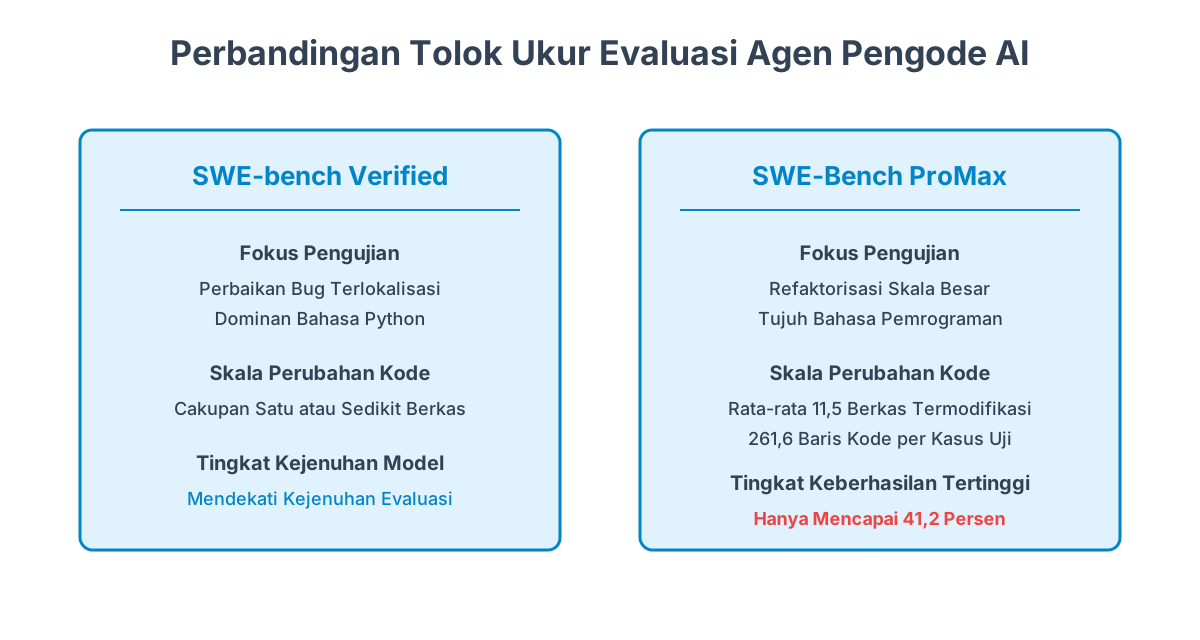
Perbandingan fitur utama dan kompleksitas pengujian antara tolok ukur perbaikan kutu dan refaktorisasi multi-berkas. Gambar: diagram oleh Metodika.
Kelemahan Tolok Ukur Lama dan Kejenuhan Evaluasi Bug Sederhana
Selama satu tahun terakhir, komunitas pengembang kecerdasan buatan global mengandalkan SWE-bench sebagai standar emas untuk mengukur kecakapan agen otonom dalam menyelesaikan isu di GitHub. Model terdepan berlomba-lomba memamerkan peningkatan persentase penyelesaian masalah hingga mendekati batas saturasi.
Namun, sebagaimana diungkapkan dalam audit independen yang dikutip oleh publikasi rekayasa perangkat lunak SwarmSignal, hampir enam puluh persen dari kasus uji yang gagal dipecahkan pada SWE-bench Verified ternyata memiliki cacat bawaan pada pengujian unit (*test suite*). Sebagian pengujian dinilai terlalu sempit sehingga menolak solusi agen yang sebenarnya benar, sementara sebagian lainnya terlalu longgar atau menguji persyaratan implisit yang tidak tercantum di deskripsi masalah.
Selain itu, evaluasi lama mayoritas hanya berpusat pada penambalan kutu (*bug fixing*) terlokalisasi di satu berkas bahasa Python, di mana model sering kali hanya menghafal pola solusi yang sudah ada di data pelatihan.
Standar Baru Refaktorisasi Lintas Berkas dan Tujuh Bahasa
Untuk menghadirkan tantangan rekayasa yang lebih realistis dan tahan uji, tim perancang menyusun SWE-Bench ProMax yang difokuskan khusus pada tugas refaktorisasi kode berskala besar tanpa mengubah perilaku fungsional sistem (*behavior-preserving refactoring*). Tolok ukur ini telah dirilis untuk publik melalui platform repositori dataset Hugging Face.
Dataset ini memuat 170 kasus uji terkurasi tangan yang diambil dari repositori kode nyata di tujuh bahasa pemrograman utama: Python, Java, TypeScript, Go, C, C++, dan Rust. Setiap kasus uji telah melewati kurasi ketat multi-tahap, di mana seluruh deskripsi masalah ditulis ulang dari awal untuk menghilangkan ambiguitas spesifikasi.
Kompleksitas refaktorisasi pada tolok ukur ini melompat jauh melampaui standar industri saat ini. Setiap tugas pengujian rata-rata melibatkan modifikasi pada 11,5 berkas kode yang saling terhubung dan menyentuh sekitar 261,6 baris kode perubahan per kasus.
Salah satu temuan paling menarik dari pengujian multibahasa ini adalah jurang performa yang signifikan antara bahasa dinamis dan bahasa dengan sistem tipe statis ketat. Agen pengode tercatat meraih tingkat keberhasilan yang relatif lebih stabil pada basis kode Python dan TypeScript karena fleksibilitas sintaksisnya, namun mengalami kesulitan ekstrem ketika dihadapkan pada restrukturisasi kode dalam bahasa Rust dan C++.
Pada bahasa Rust, agen AI berulang kali terbentur pada aturan sistem kepemilikan memori (*borrow checker*) dan masa hidup variabel (*lifetimes*). Ketika refaktorisasi melibatkan perubahan tanda tangan fungsi atau pemindahan struktur data lintas modul, agen kerap menghasilkan kode yang secara logika tampak benar namun gagal dikompilasi oleh kompilator. Kegagalan kompilasi ini membuktikan bahwa agen pengode saat ini masih mengandalkan pencocokan pola probabilitas kata daripada penalaran semantik mendalam mengenai model memori sistem.
Hasil Uji Model Terdepan yang Masih Rendah
Dalam dokumentasi teknis yang dipublikasikan di portal resmi SWE-bench, tim peneliti menguji serangkaian model fondasi terdepan menggunakan dua kerangka perancah agen (*agent scaffolds*). Hasilnya membuktikan bahwa refaktorisasi repositori skala besar masih menjadi tantangan yang sangat berat bagi kecerdasan buatan.
Model terunggul di dunia saat ini tercatat hanya mampu meraih tingkat penyelesaian sukses sebesar 41,2 persen pada SWE-Bench ProMax. Kegagalan umum yang dialami agen meliputi hilangnya konsistensi struktur saat memodifikasi banyak berkas sekaligus, tersesat dalam eksplorasi logika yang tidak produktif, serta ketidakmampuan menjaga kompatibilitas antarmuka fungsi di luar berkas utama.
Data ini menegaskan bahwa tolok ukur baru ini menyediakan ruang tantangan yang sangat luas (*unsaturated benchmark*) untuk memandu arah riset agen pengode otonom selama beberapa tahun ke depan.
Temuan ini selaras dengan fenomena perilaku pengembang yang diungkap dalam studi empiris terpisah mengenai interaksi manusia dan kecerdasan buatan. Sebagian besar insinyur perangkat lunak enggan menghabiskan waktu berjam-jam untuk memperbaiki kode AI yang rumit; bila saran refaktorisasi yang diberikan oleh agen kecerdasan buatan memicu puluhan kesalahan kompilasi baru di berkas lain, pengembang cenderung langsung membatalkan (*revert*) seluruh perubahan tersebut dan mengerjakannya secara manual.
Ketidakmampuan agen dalam mengelola efek samping lintas berkas (*cross-file side effects*) menjadi pekerjaan rumah terbesar bagi perancang arsitektur agen masa depan. Diperlukan integrasi yang lebih solid antara model bahasa besar dengan perkakas analisis kode statis (*Language Server Protocol* - LSP) agar agen dapat mendeteksi dampak perubahan fungsi terhadap ratusan modul pemanggil sebelum mengajukan draf penggabungan kode.
Relevansi bagi Pengembang Perangkat Lunak di Indonesia
Bagi kalangan praktisi rekayasa perangkat lunak, pimpinan teknologi rintisan, dan mahasiswa ilmu komputer di Indonesia, temuan dari SWE-Bench ProMax memberikan wawasan berharga mengenai batasan nyata kemampuan asisten pemrograman AI masa kini.
Meskipun alat bantu pengodean cerdas sangat terampil menghasilkan cuplikan fungsi atau menulis skrip pengujian sederhana, tugas perancangan arsitektur, pemeliharaan sistem terdistribusi, serta restrukturisasi basis kode besar tetap membutuhkan pertimbangan mendalam dari insinyur perangkat lunak manusia.
Evolusi tolok ukur ini juga mendorong kurikulum pendidikan informatika di tanah air untuk lebih menekankan penguasaan pola perancangan perangkat lunak (*design patterns*) dan manajemen dependensi kode multi-modul. Kemampuan mengarahkan dan mengawasi refaktorisasi sistem secara holistik akan menjadi pembeda utama antara pengembang biasa dengan insinyur senior di era komputasi berbasis agen otonom.
Gambar sampul: Suhiresearch, commons.wikimedia.org, lisensi CC BY-SA.
Bagikan berita ini