Studi Novelty-Bench Ai2 Buktikan Model Bahasa Belum Andal Menilai Kebaruan Gagasan Riset Ilmiah
Riset terbaru Allen Institute for AI mengungkapkan bahwa model bahasa besar masih rentan mengalami bias posisi dan sensitivitas prompt saat mengevaluasi orisinalitas gagasan sains.
Sumber: Hugging Face 5 menit baca
Lembaga riset nirlaba Allen Institute for AI resmi merilis laporan studi mendalam bertajuk Old Ideas, Novel Problems bersamaan dengan peluncuran repositori tolok ukur Novelty-Bench pada 27 Oktober 2026 di Seattle, Amerika Serikat. Riset ini menguji secara sistematis sejauh mana model bahasa besar (LLM) dapat dipercaya untuk bertindak sebagai juri penilai orisinalitas dan kebaruan suatu gagasan penelitian ilmiah.
Sebagaimana dipublikasikan melalui blog resmi Hugging Face, temuan tim peneliti menunjukkan bahwa model kecerdasan buatan mutakhir saat ini belum memiliki landasan penalaran yang konsisten untuk membedakan inovasi sains orisinal dari gagasan usang yang dikemas ulang. Fenomena ketidakstabilan penilaian ini menjadi peringatan serius di tengah maraknya wacana otomatisasi proses peninjauan manuskrip ilmiah dan seleksi proposal riset di tingkat global.
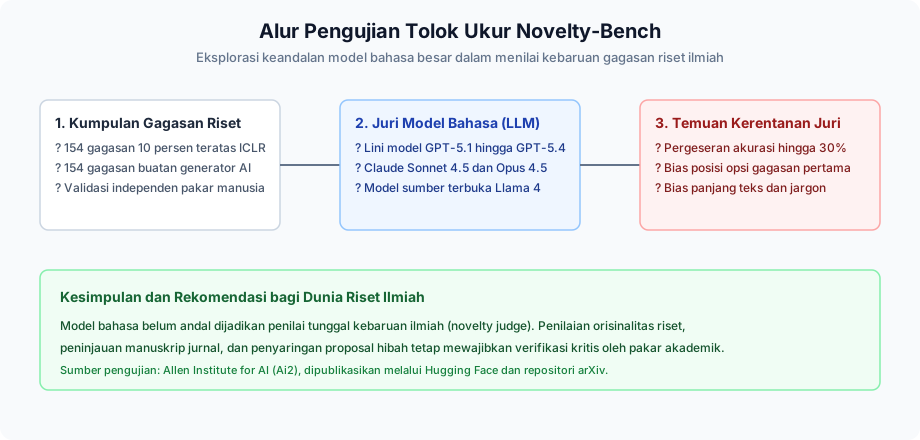
Alur evaluasi kebaruan gagasan riset ilmiah dan temuan bias kognitif model bahasa besar dalam tolok ukur Novelty-Bench. Gambar: diagram oleh Metodika.
Metodologi Kurasi Data Berbasis Konferensi ICLR
Untuk membangun tolok ukur evaluasi yang objektif, para peneliti merancang pipa seleksi otomatis dengan memanfaatkan ribuan ulasan sejawat dari konferensi kecerdasan buatan terkemuka ICLR 2026. Alih-alih sekadar menjadikan status penerimaan makalah sebagai tolok ukur keberhasilan, tim mengurai teks ulasan guna mengekstraksi penilaian kebaruan yang secara eksplisit disepakati oleh para peninjau manusia.
Melalui proses penyaringan ketat tersebut, tim menyusun kumpulan data primer yang memuat 154 gagasan ilmiah teratas karya peneliti manusia yang berada pada persentil 10 persen terbaik di bidangnya. Gagasan-gagasan unggulan ini kemudian dipasangkan dengan 154 gagasan alternatif yang digenerasikan oleh model AI sederhana untuk membentuk pasangan uji komparatif.
Pengujian performa juri dilakukan terhadap enam model fondasi komersial dan sumber terbuka kelas atas, meliputi GPT-5.1, GPT-5.2, GPT-5.4, Claude Sonnet 4.5, Claude Opus 4.5, serta model terbuka Llama 4. Setiap model diminta menentukan gagasan mana yang menghadirkan kontribusi ilmiah lebih baru dan substantif ketika disandingkan secara berdampingan.
Guna memvalidasi ketepatan tolok ukur, panel pakar manusia independen melakukan peninjauan mendalam terhadap 30 pasangan kasus yang paling ambigu, khususnya pada skenario di mana model juri terkuat sekalipun menghasilkan keputusan yang keliru. Hasil audit manusia menegaskan bahwa sebagian besar kegagalan model bersumber dari ketidakmampuan membedakan variasi istilah teknis semu dari lompatan paradigma ilmiah yang hakiki.
Kerentanan Evaluasi dan Pergeseran Akurasi Drastis
Hasil pengujian yang diunggah ke repositori pracetak ilmiah arXiv memperlihatkan tingkat kerapuhan logika yang mengejutkan pada seluruh model yang diuji. Ketepatan penilaian model terbukti sangat sensitif terhadap perubahan redaksional instruksi (prompt), bahkan ketika pasangan gagasan yang dinilai sama sekali tidak diubah.
Sebagai contoh konkret, model GPT-5.4 mengalami pergeseran akurasi hingga tiga puluh poin persentase ketika format pertanyaan diubah dari pemeringkatan kriteria bertahap menjadi perbandingan biner langsung. Inkonsistensi setinggi ini menegaskan bahwa model sering kali tidak benar-benar memahami substansi kontribusi metodologis, melainkan sekadar bereaksi terhadap pola sintaksis pertanyaan.
Selain sensitivitas instruksi, evaluasi juri mesin juga terjangkit bias posisi yang akut, di mana model cenderung memprioritaskan gagasan yang dicantumkan pada urutan pertama dalam teks masukan. Model juga memperlihatkan bias panjang kalimat, dengan kecenderungan keliru menganggap paparan teknis yang bertele-tele dan sarat istilah rumit sebagai gagasan yang lebih berbobot daripada usulan riset yang ringkas namun revolusioner.
Analisis lanjutan pada data metrik mendapati bahwa tingkat kesepakatan antarmodel (inter-model agreement) berada di bawah lima puluh persen. Dua model berkinerja tinggi kerap memberikan vonis yang bertolak belakang terhadap satu berkas ide yang sama, menyingkap belum adanya standar representasi pengetahuan ilmiah yang stabil di dalam lapisan pembobotan jaringan saraf tiruan saat ini.
Tanggapan Komunitas Akademik dan Batasan Otomasi
Sebagaimana disorot dalam ulasan media teknologi terkemuka VentureBeat, ketergantungan pada model kecerdasan buatan sebagai penyaring proposal penelitian membawa risiko epistemologis yang berbahaya bagi ekosistem sains. Asisten mesin kerap mengalami halusinasi rujukan pustaka, menganggap algoritma klasik yang telah dipublikasikan dua dekade silam sebagai temuan baru, sembari mengabaikan paradigma matematika orisinal hanya karena tidak familier dalam data latihnya.
Sejumlah pakar etika sains menegaskan bahwa penilaian kebaruan bukan sekadar persoalan pencocokan kata kunci semantik, melainkan pemahaman konteks historis dan batas metodologis suatu disiplin ilmu. Penilaian terhadap bobot pemecahan masalah membutuhkan pertimbangan nilai ilmiah yang hingga kini hanya dapat dipertanggungjawabkan melalui penalaran kritis manusia.
Oleh karena itu, konsorsium peneliti merekomendasikan agar platform pengelola hibah riset dan dewan redaksi jurnal tidak menerapkan penyaringan otomatis berbasis LLM secara mandiri. Pemanfaatan teknologi kecerdasan buatan disarankan sebatas alat bantu eksplorasi pustaka pembanding, sementara vonis kebaruan gagasan wajib tetap berada di bawah wewenang peninjau sejawat manusia.
Pada fase pengembangan berikutnya, konsorsium Ai2 berencana memperluas cakupan Novelty-Bench dengan mengintegrasikan mesin pencarian literatur aktif berbasis Semantic Scholar. Integrasi ini bertujuan memaksa model melakukan penelusuran bukti empiris dari basis data jutaan makalah terbuka sebelum menjatuhkan kesimpulan penilaian.
Relevansi bagi Peneliti dan Mahasiswa di Indonesia
Bagi komunitas akademik, dosen pembimbing, dan mahasiswa tingkat akhir di perguruan tinggi Indonesia, temuan studi ini menghadirkan wawasan metodologis yang sangat fundamental dalam penyusunan karya ilmiah. Dalam proses perumusan bab pendahuluan, identifikasi kebaruan penelitian (state of the art) kerap menjadi bagian yang paling sulit dan paling sering dikritisi oleh dewan penguji skripsi maupun reviewer jurnal bereputasi.
Banyak peneliti pemula saat ini tergoda untuk menyerahkan penelusuran celah riset dan penilaian kontribusi teoritis sepenuhnya kepada generator teks kecerdasan buatan. Padahal, temuan Novelty-Bench membuktikan bahwa model bahasa kerap memberikan konfirmasi palsu yang meyakinkan, membuat penulis merasa gagasannya orisinal padahal topik serupa telah dibahas tuntas dalam literatur terdahulu.
Kecakapan membaca kritis jurnal primer, membedah matriks perbandingan penelitian terdahulu secara manual, dan merumuskan argumen kebaruan yang runtut tetap menjadi kompetensi utama yang tidak tergantikan. Validasi silang terhadap referensi terindeks secara teliti merupakan benteng perlindungan terbaik agar riset yang diajukan tidak ditolak akibat kekeliruan klaim orisinalitas.
Langkah maju yang ditunjukkan oleh inisiatif repositori terbuka ini mempertegas pentingnya transparansi metodologi evaluasi di era kecerdasan komputasi modern. Otomasi teknologi seyogianya diposisikan untuk memperkuat ketelitian pengumpulan data awal, bukan mengikis integritas dan kedalaman dialektika intelektual yang menjadi pilar peradaban sains.
Gambar sampul: Calvin West, commons.wikimedia.org, lisensi CC BY-SA.
Bagikan berita ini