OpenAI, Google, dan Anthropic Sepakati Standar Bersama robots.txt untuk Blokir Pelatihan AI
OpenAI bersama Google, Anthropic, dan Microsoft menyepakati standar terpadu robots.txt berbasis token IETF guna memudahkan situs web menolak pelatihan model AI.
Sumber: OpenAI 5 menit baca
Raksasa pengembang kecerdasan buatan OpenAI bersama Google, Anthropic, dan Microsoft resmi bersepakat untuk mengadopsi standar bersama berkas protokol perayapan web guna memudahkan pengelola situs menentukan izin pelatihan model kecerdasan buatan pada akhir Oktober 2026 di San Francisco, Amerika Serikat.
Melalui pengumuman resmi yang dipublikasikan di laman OpenAI, inisiatif ini dirancang untuk menjawab keluhan panjang para penerbit konten digital dan pemilik situs web yang selama ini kewalahan mengatur pembatasan perayapan data secara manual untuk puluhan perusahaan teknologi yang berbeda.
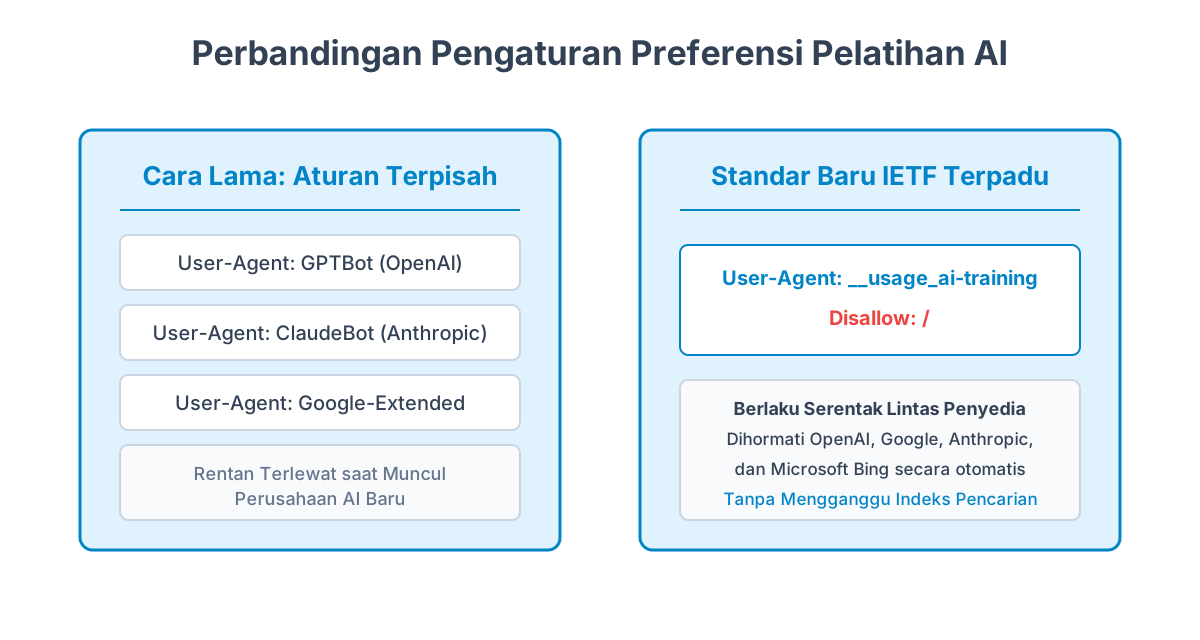
Perbandingan alur pemblokiran perayap pelatihan AI dari cara terpisah menuju standar terpadu. Gambar: diagram oleh Metodika.
Penyederhanaan Kendali Lewat Satu Baris Protokol Bersama
Selama beberapa tahun terakhir, pengelola situs web yang ingin melindungi artikel atau karya cipta mereka dari pelatihan model bahasa besar (LLM) wajib menyusun baris aturan panjang di dalam berkas robots.txt. Pengelola harus mendaftarkan agen perayap satu per satu, mulai dari GPTBot milik OpenAI, ClaudeBot milik Anthropic, Google-Extended milik Google, hingga perayap milik Microsoft dan pengembang AI rintisan lainnya.
Sebagaimana dilaporkan oleh publikasi teknologi The Next Web, pendekatan terfragmentasi tersebut sangat merepotkan penerbit karena mereka harus terus memperbarui berkas setiap kali ada pengembang kecerdasan buatan baru yang merilis bot pengumpul data ke internet. Bila ada satu nama bot yang terlewat, data situs web tersebut berisiko tetap tersedot tanpa persetujuan pengelola.
Melalui kesepakatan terbaru ini, konsorsium industri menyetujui proposal standardisasi yang diajukan ke kelompok kerja AIPREF di bawah Internet Engineering Task Force (IETF). Standar ini memperkenalkan token agen pengguna terpadu bernama __usage_ai-training. Dengan menambahkan arahan penolakan pada token tunggal ini, pemilik situs web dapat langsung menolak pelatihan model kecerdasan buatan dari seluruh penyedia yang berpartisipasi hanya dengan satu perintah ringkas:
User-Agent: __usage_ai-training
Disallow: /
Kendati demikian, standar ini tetap memberikan fleksibilitas tinggi bagi penerbit yang ingin membuka sebagian kontennya untuk publikasi atau promosi melalui penambahan baris Allow:, misalnya untuk folder rilis pers atau materi publikasi tertentu.
Langkah standardisasi ini tidak lepas dari rentetan sengketa hukum hak cipta yang melanda industri kecerdasan buatan sepanjang dua tahun terakhir. Gugatan hukum berskala besar yang diajukan oleh berbagai penerbit media internasional ternama seperti The New York Times terhadap OpenAI dan Microsoft menjadi pemicu utama di balik desakan perlunya mekanisme izin yang lebih transparan dan berkekuatan teknis mengikat.
Sebelum adanya inisiatif ini, banyak pengembang kecerdasan buatan berdalih bahwa pengambilan data publik di internet dilindungi oleh doktrin penggunaan wajar (*fair use*). Namun para pemilik hak cipta berargumen bahwa penyerapan karya jurnalistik dan basis data komersial tanpa kompensasi telah mencederai model bisnis penerbitan. Dengan adanya token standardisasi yang diakui secara luas, batas antara konten yang diizinkan untuk pelatihan dan konten yang dilarang menjadi jauh lebih terang secara hukum maupun teknis.
Pemisahan Tegas Antara Mesin Pencari dan Pelatihan Model
Dalam ulasan mendalam yang dimuat oleh portal berita teknologi Engadget, para analis infrastruktur web menyambut positif komitmen industri untuk memisahkan secara tegas fungsi pencarian web dari aktivitas pelatihan model kecerdasan buatan generatif.
Banyak pemilik situs web sebelumnya merasa gamang memblokir perayap bot karena khawatir situs mereka akan hilang dari hasil pencarian Google Search atau Bing Search. Ketakutan tersebut kini terjawab karena token __usage_ai-training hanya berlaku khusus untuk konsumsi data pelatihan model pondasi kecerdasan buatan, bukan untuk pengindeksan mesin pencari.
Pihak OpenAI menegaskan bahwa perayap pencarian seperti OAI-SearchBot (yang bertugas menyajikan kutipan sumber pada fitur ChatGPT Search) akan tetap dapat membaca situs selama tidak diblokir secara eksplisit. Hal serupa berlaku bagi Google, di mana penerapan token bersama ini akan diartikan setara dengan penolakan terhadap Google-Extended tanpa memengaruhi peringkat laman pada pencarian umum.
Jadwal Peluncuran Bertahap Lintas Perusahaan Teknologi
Meskipun konsensus telah dicapai, jadwal implementasi teknis di lapangan akan berlangsung secara bertahap sepanjang akhir 2026 hingga awal 2027 mendatang. Laporan media teknologi nasional Telset.id menyoroti perbedaan linimasa adopsi antarpengembang:
- Anthropic: Menjadi pelopor rancangan proposal IETF lewat inisiatif Kevin Kelley dan langsung mengaktifkan dukungan pematuhan token baru ini di jaringan perayapnya.
- OpenAI: Berkomitmen menerapkan kepatuhan terhadap token bersama ini secara penuh dalam beberapa bulan ke depan.
- Microsoft: Menjadwalkan integrasi protokol baru pada mesin Bing mulai 1 Februari 2027.
- Google: Menargetkan kesiapan sistem perayap mereka pada kuartal pertama tahun 2027 mendatang.
Dari sisi arsitektur protokol internet, tata kelola perayapan web selama ini berpegang pada standar RFC 9309 yang mengatur penafsiran berkas robots.txt. Protokol klasik yang dirancang sejak era awal web pada dekade 1990-an tersebut awalnya hanya ditujukan untuk mengelola beban server dan mencegah terjadinya kemacetan lalu lintas jaringan akibat perayapan mesin pencari yang terlalu agresif.
Perkembangan pesat teknologi kecerdasan buatan generatif menuntut perluasan fungsi robots.txt dari sekadar pengatur izin akses unduhan (*access control*) menjadi sarana pernyataan hak penggunaan konten (*usage rights declaration*). Token __usage_ai-training memanfaatkan fleksibilitas nama agen pengguna tanpa harus merombak struktur dasar RFC 9309, sehingga perangkat lunak server web yang ada saat ini dapat langsung kompatibel tanpa memerlukan pembaruan tambalan (*patch*) perangkat lunak yang rumit.
Penyedia jaringan pengiriman konten (CDN) global seperti Cloudflare dan Fastly dilaporkan tengah mempersiapkan fitur sakelar otomatis di dasbor mereka. Melalui fitur tersebut, pengelola situs web dapat menyematkan aturan penolakan pelatihan AI ke seluruh domain mereka hanya dengan menggeser satu tombol kendali tanpa perlu mengedit berkas teks di server secara manual.
Dampak dan Manfaat bagi Ekosistem Digital di Indonesia
Bagi industri media massa daring, pengelola portal kampus, institusi penerbit jurnal, serta pengembang web di Indonesia, kehadiran standar terpadu ini memberikan kepastian hukum dan kemudahan teknis yang sangat signifikan. Pengelola infrastruktur server di tanah air tidak perlu lagi menghabiskan waktu memantau log lalu lintas perayap asing yang kerap membebani kapasitas lebar pita (*bandwidth*).
Komunitas akademik dan universitas di Indonesia yang mengelola repositori karya ilmiah dapat memanfaatkan satu baris perintah ini untuk melindungi skripsi, tesis, dan naskah penelitian dosen dari penyerapan tanpa izin oleh korporasi kecerdasan buatan global, sembari tetap memastikan bahwa naskah tersebut tetap mudah ditemukan oleh mahasiswa dan peneliti melalui mesin pencari publik.
Langkah kolaboratif ini mencerminkan pergeseran penting dalam tata kelola kecerdasan buatan global, di mana hak kepemilikan dan kedaulatan data pemilik konten mulai diakui melalui mekanisme standar internet terbuka yang transparan.
Gambar sampul: Christopher Bowns, commons.wikimedia.org, lisensi CC BY-SA.
Bagikan berita ini